2.상세분석
분석
이제 0.발표내용을 1.개념정리를 통해서 정리한 내용을 바탕으로 분석해보겠습니다.
목표 정의
이번 사례의 목표는 CPU 사용률을 Kernel 레벨에서 eBPF를 통해 자세히 분석하여 최적화함에 있다
문제 정의
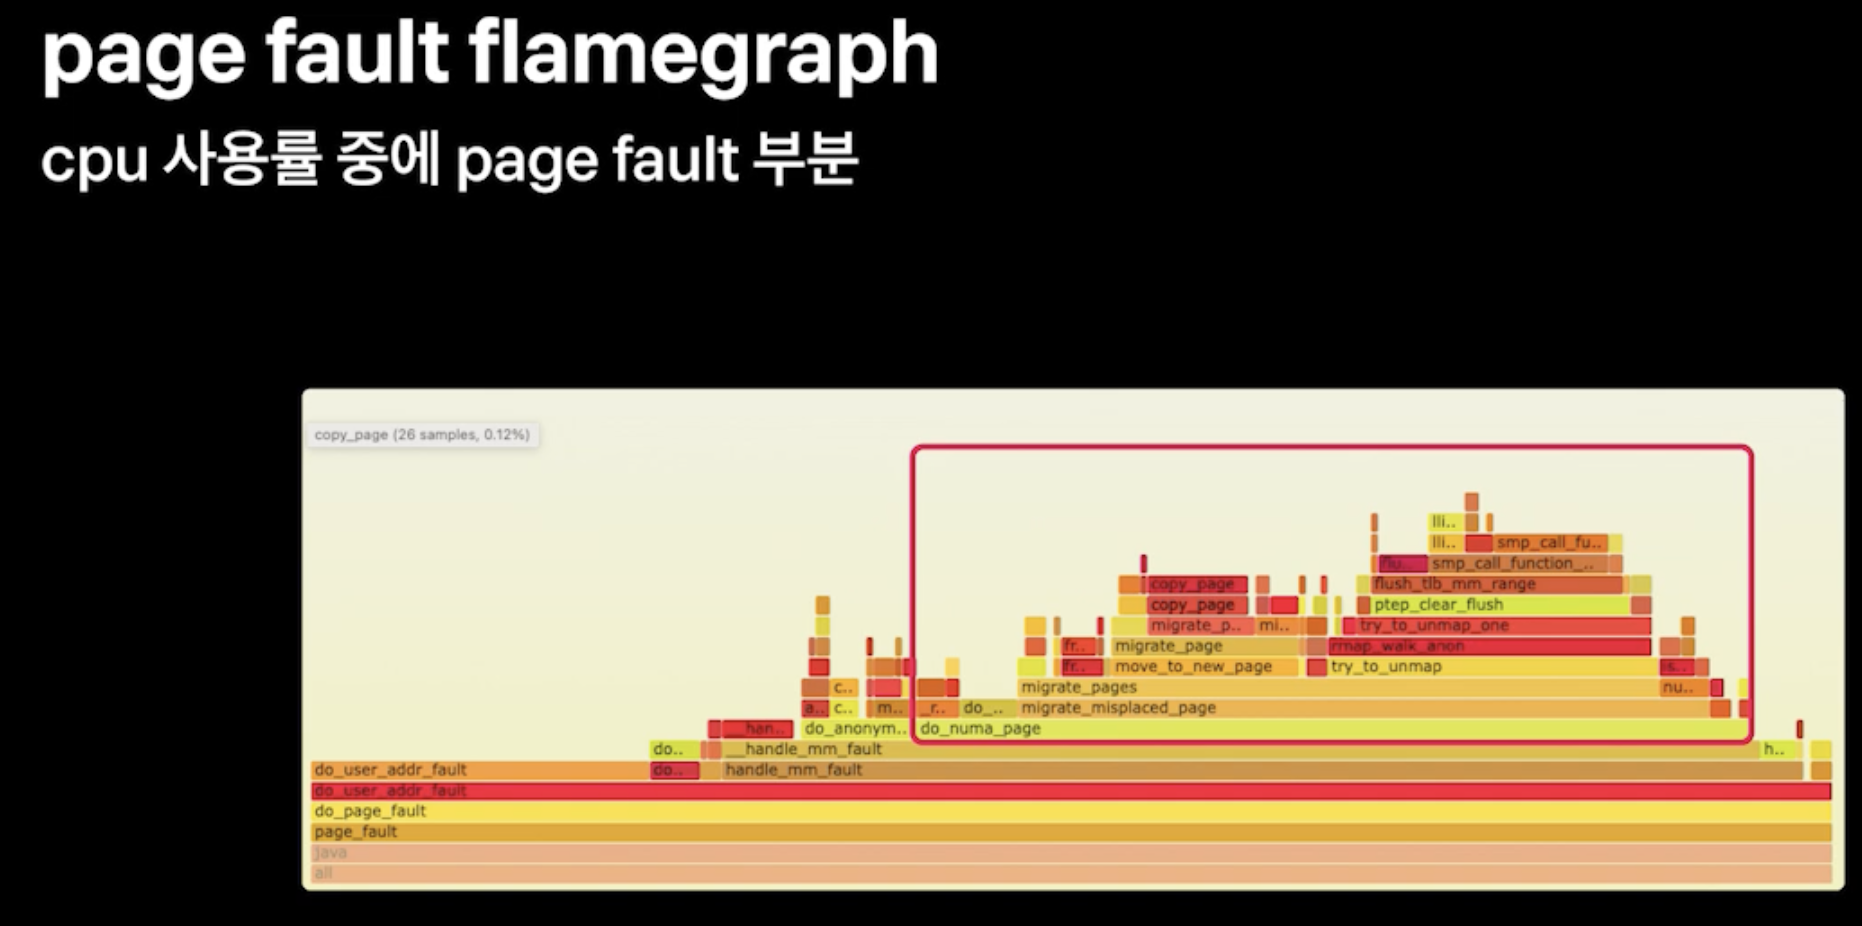
이번 사례의 문제를 한줄로 정리하면 다음과 같이 작성할 수 있을 것 같습니다.
CPU 사용률 중 가장 많은 부분을 차지하는 page fault에서
do_numa_page동작 중migrate_misplaced_page수행 시간이 전체의 50% 이상을 차지한다
- CPU 사용률이란 전체 백분율에서 Busy State가 차지했던 비율을 의미함
- Busy State가 의미하는 게 연산을 오로지 했다는 것은 아니고, Memory를 읽고 쓰는 데 걸리는 시간인 stalled 이라고 불리는 Memory IO 시간도 포함이 되어 있음
- Memory IO 중 가장 오래 걸리는 부분이 바로 page fault이고 이는 물리적으로 하드웨어 접근까지 필요하기 때문임
- page fault에서 migrate_misplaced_page 시간을 단축시키면 전체적인 page fault 시간을 단축시킬 수 있고 이를 통해 CPU 사용률을 최적화할 수 있음
do_numa_page란?
이전 글에서 알아본대로 커널은 지속적으로 Auto NUMA Balancing을 맞추려고 노력하고 있습니다.
이러한 동작을 구현하기 위해 NUMA hinting fault가 발생한다고 알아보았고, 이러한 fault가 발생하면 커널에서 호출하는 함수가 바로 do_numa_page입니다.
해당 함수의 코드는1 아래와 같습니다.
/* mm/memory.c — NUMA hinting fault 처리 (folio 기반, 간략화) */
static vm_fault_t do_numa_page(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    struct folio *folio;
    int nid = NUMA_NO_NODE, last_cpupid = -1;
    int target_nid, nr_pages;
    bool writable;
    pte_t pte, old_pte;
    int flags = 0;
    /* PROT_NONE으로 바꿔둔 PTE를 원래 권한으로 복원 */
    old_pte = ptep_get(vmf->pte);
    pte = pte_modify(old_pte, vma->vm_page_prot);
    writable = pte_write(pte);
    /* struct page 대신 folio 단위로 처리 (large folio 지원) */
    folio = vm_normal_folio(vma, vmf->address, pte);
    if (!folio || folio_is_zone_device(folio))
        goto out_map;
    nid = folio_nid(folio);          /* folio의 현재 노드 */
    nr_pages = folio_nr_pages(folio);
    /* 접근 태스크와 folio 노드 비교 → 마이그레이션 대상
     * 노드 결정 + cpupid 디코딩 */
    target_nid = numa_migrate_check(folio, vmf, vmf->address,
                                    &flags, writable, &last_cpupid);
    if (target_nid == NUMA_NO_NODE)
        goto out_map;                /* 이미 최적 위치 */
    /* 격리 사전 검사: 공유 실행/더티 파일 folio 제외,
     * 대상 노드 워터마크 확인 후 LRU 격리까지 수행 */
    if (migrate_misplaced_folio_prepare(folio, vma, target_nid)) {
        flags |= TNF_MIGRATE_FAIL;
        goto out;
    }
    /* 실제 마이그레이션 수행 (MIGRATE_ASYNC) */
    if (migrate_misplaced_folio(folio, target_nid))
        flags |= TNF_MIGRATE_FAIL;
out:
    /* NUMA 폴트 통계 업데이트 (folio 크기 반영) */
    if (nid != NUMA_NO_NODE)
        task_numa_fault(last_cpupid, nid, nr_pages, flags);
    return 0;
out_map:
    /* 매핑만 복원하고 종료 (PTE 권한 재설정) */
    ...
}
동작을 살펴보면,
- CPU(태스크)가 있는 노드와 데이터(folio)가 있는 노드를 비교합니다
- 같은 노드에 있지 않은 경우 마이그레이션 (migrate_misplaced_folio)을 수행합니다
즉 정리하면, do_numa_page는 지속적으로 호출될 수 밖에 없습니다. 이는 Auto NUMA Balancing이 켜져있기 때문입니다. 이 동작에서 가장 많은 시간을 할애하는 것이 바로 마이그레이션 migrate_misplaced_page 입니다.
따라서 migrate_misplaced_page이 발생하지 않게 하면 전체적인 do_numa_page 시간을 줄일 수 있습니다.
migrate_misplaced_page이 발생하는 이유
이전 글에서 알아본대로 migrate_misplaced_page가 발생하는 이유는 Auto NUMA Balancing 때문이며, Auto NUMA Balancing이 필요한 이유는 아래와 같은 상황들 때문입니다.
1. 프로그램이 노드0의 코어에서 시작 → 메모리도 노드0에 할당됨 (first-touch)
2. 시간이 흘러, 리눅스 스케줄러가 부하 분산을 위해
   이 프로그램을 노드1의 코어로 옮김
3. 결과: 코어는 노드1인데, 메모리는 여전히 노드0에 있음
   → 매번 메모리 접근할 때마다 원격(remote) 접근 발생 → 느려짐
즉 정리하면 리눅스 스케줄러에 의해 task가 실행되는 CPU 코어의 위치가 변경될 수 있고 이로 인해 NUMA 정렬이 깨지면 Auto NUMA Balancing에 의해 실행 중인 CPU 코어 혹은 저장된 메모리의 위치를 변경합니다.
따라서 이를 해결하는 가장 간단한 방법은 task가 실행되는 CPU, 메모리를 동일한 NUMA 노드로 고정하는 것입니다.
Kubernetes에서 프로세스를 자원에 배치하는 방법 - kubelet
Kubernetes에서 프로세스를 실제 노드에서 실행하는 역할은 kubelet이 수행합니다. kube-scheduler에 의해서 각 노드의 자원 할당 상태를 확인하여 새로운 Pod가 호스팅될 노드가 결정되고, 해당 노드의 kubelet은 자신의 이름이 적인 Pendig 상태의 Pod의 정보를 읽어 실행하게 됩니다. 이제 Pod의 정보를 읽은 뒤 어떻게 실제 자원까지 할당하는 지 알아보겠습니다.
1. syncLoop
kubelet이 노드에서 실행되면 syncLoop가 무한 반복됩니다. syncLoop는 세가지 채널(file, apiserver, http)을 통해 변경 사항을 감지하고 이를 반영합니다.
여기서 한번 파드가 새로 생성되었다는 흐름으로 코드를 따라가 보겠습니다.
// syncLoop is the main loop for processing changes. It watches for changes from
// three channels (file, apiserver, and http) and creates a union of them. For
// any new change seen, will run a sync against desired state and running state. If
// no changes are seen to the configuration, will synchronize the last known desired
// state every sync-frequency seconds. Never returns.
func (kl *Kubelet) syncLoop(ctx context.Context, updates <-chan kubetypes.PodUpdate, handler SyncHandler) {
    klog.InfoS("Starting kubelet main sync loop")
    ...

    for {
        if err := kl.runtimeState.runtimeErrors(); err != nil {
            klog.ErrorS(err, "Skipping pod synchronization")
            // exponential backoff
            time.Sleep(duration)
            duration = time.Duration(math.Min(float64(max), factor*float64(duration)))
            continue
        }
        // reset backoff if we have a success
        duration = base

        kl.syncLoopMonitor.Store(kl.clock.Now())
        if !kl.syncLoopIteration(ctx, updates, handler, syncTicker.C, housekeepingTicker.C, plegCh) {
            break
        }
        kl.syncLoopMonitor.Store(kl.clock.Now())
    }
}
각 루프마다 kl.syncLoopIteration을 호출하게 되고 Pod가 추가된 경우 이 함수 안에서 handler.HandlePodAdditions를 호출하게 됩니다.
func (kl *Kubelet) syncLoopIteration(ctx context.Context, configCh <-chan kubetypes.PodUpdate, handler SyncHandler,
    syncCh <-chan time.Time, housekeepingCh <-chan time.Time, plegCh <-chan *pleg.PodLifecycleEvent) bool {
    select {
    case u, open := <-configCh:
        // Update from a config source; dispatch it to the right handler
        // callback.
        if !open {
            klog.ErrorS(nil, "Update channel is closed, exiting the sync loop")
            return false
        }

        switch u.Op {
        case kubetypes.ADD:
            klog.V(2).InfoS("SyncLoop ADD", "source", u.Source, "pods", klog.KObjSlice(u.Pods))
            // After restarting, kubelet will get all existing pods through
            // ADD as if they are new pods. These pods will then go through the
            // admission process and *may* be rejected. This can be resolved
            // once we have checkpointing.
            handler.HandlePodAdditions(u.Pods)
        ...
    return true
}
handler.HandlePodAdditions에서는 이 Pod를 노드 안으로 들여도 되는 지 확인하는 kl.canAdmitPod을 호출하게되고
func (kl *Kubelet) HandlePodAdditions(pods []*v1.Pod) {
    ...
    for _, pod := range pods {
        existingPods := kl.podManager.GetPods()
        // Always add the pod to the pod manager. Kubelet relies on the pod
        // manager as the source of truth for the desired state. If a pod does
        // not exist in the pod manager, it means that it has been deleted in
        // the apiserver and no action (other than cleanup) is required.
        kl.podManager.AddPod(pod)

        pod, mirrorPod, wasMirror := kl.podManager.GetPodAndMirrorPod(pod)
        if wasMirror {
            if pod == nil {
                klog.V(2).InfoS("Unable to find pod for mirror pod, skipping", "mirrorPod", klog.KObj(mirrorPod), "mirrorPodUID", mirrorPod.UID)
                continue
            }
            kl.podWorkers.UpdatePod(UpdatePodOptions{
                Pod:        pod,
                MirrorPod:  mirrorPod,
                UpdateType: kubetypes.SyncPodUpdate,
                StartTime:  start,
            })
            continue
        }

        // Only go through the admission process if the pod is not requested
        // for termination by another part of the kubelet. If the pod is already
        // using resources (previously admitted), the pod worker is going to be
        // shutting it down. If the pod hasn't started yet, we know that when
        // the pod worker is invoked it will also avoid setting up the pod, so
        // we simply avoid doing any work.
        // We also do not try to admit the pod that is already in terminated state.
        if !kl.podWorkers.IsPodTerminationRequested(pod.UID) && !podutil.IsPodPhaseTerminal(pod.Status.Phase) {
            // We failed pods that we rejected, so activePods include all admitted
            // pods that are alive.
            activePods := kl.filterOutInactivePods(existingPods)

            if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
                // To handle kubelet restarts, test pod admissibility using AllocatedResources values
                // (for cpu & memory) from checkpoint store. If found, that is the source of truth.
                podCopy := pod.DeepCopy()
                kl.updateContainerResourceAllocation(podCopy)

                // Check if we can admit the pod; if not, reject it.
                if ok, reason, message := kl.canAdmitPod(activePods, podCopy); !ok {
                    kl.rejectPod(pod, reason, message)
                    continue
                }
                // For new pod, checkpoint the resource values at which the Pod has been admitted
                if err := kl.statusManager.SetPodAllocation(podCopy); err != nil {
                    //TODO(vinaykul,InPlacePodVerticalScaling): Can we recover from this in some way? Investigate
                    klog.ErrorS(err, "SetPodAllocation failed", "pod", klog.KObj(pod))
                }
            } else {
                // Check if we can admit the pod; if not, reject it.
                if ok, reason, message := kl.canAdmitPod(activePods, pod); !ok {
                    kl.rejectPod(pod, reason, message)
                    continue
                }
            }
        }
        kl.podWorkers.UpdatePod(UpdatePodOptions{
            Pod:        pod,
            MirrorPod:  mirrorPod,
            UpdateType: kubetypes.SyncPodCreate,
            StartTime:  start,
        })
    }
}
kl.canAdmitPod안에서는 등록된 모든 kl.admitHandlers를 돌면서 실제로 들여도 되는 지 하나씩 점검하기 위해 각 핸들러마다 podAdmitHandler.Admit를 호출합니다.
이때 하나의 핸들러라도 Pod Admit을 거절하게 되면 해당 Pod는 노드에서 호스팅 되지 못하고 거절됩니다.
func (kl *Kubelet) canAdmitPod(pods []*v1.Pod, pod *v1.Pod) (bool, string, string) {
    // the kubelet will invoke each pod admit handler in sequence
    // if any handler rejects, the pod is rejected.
    // TODO: move out of disk check into a pod admitter
    // TODO: out of resource eviction should have a pod admitter call-out
    attrs := &lifecycle.PodAdmitAttributes{Pod: pod, OtherPods: pods}
    if utilfeature.DefaultFeatureGate.Enabled(features.InPlacePodVerticalScaling) {
        // Use allocated resources values from checkpoint store (source of truth) to determine fit
        otherPods := make([]*v1.Pod, 0, len(pods))
        for _, p := range pods {
            op := p.DeepCopy()
            kl.updateContainerResourceAllocation(op)

            otherPods = append(otherPods, op)
        }
        attrs.OtherPods = otherPods
    }
    for _, podAdmitHandler := range kl.admitHandlers {
        if result := podAdmitHandler.Admit(attrs); !result.Admit {
            return false, result.Reason, result.Message
        }
    }

    return true, "", ""
}
그렇다면 각 핸들러가 수행하는 podAdmitHandler.Admit은 정확히 어떤 것일까요? 이것을 알기 위해 어떤 핸들러들이 등록되는 지 확인해보겠습니다.
2. admitHandlers
admitHandler들은 스케줄러가 이미 이 노드로 보내기로 결정한 파드를, kubelet이 로컬에서 마지막으로 한 번 더 체크해서 실제로 실행 가능한지 최종 승인/거부하는 문지기(gatekeeper)입니다.
스케줄러는 etcd에 저장된 "예상" 상태를 보고 결정하지만, 실제 노드는:
- 그 사이 다른 static pod가 리소스를 이미 써버렸을 수 있고
- 메모리/디스크 압박(pressure) 상태로 바뀌었을 수 있고
- 노드가 shutdown 절차를 시작했을 수 있고
- CPU/메모리/디바이스를 NUMA 정렬해서 배타적으로 줘야 하는데 실제로는 그럴 여유가 없을 수도 있습니다
그래서 kubelet은 "스케줄러가 시켰다고 무조건 실행"하지 않고, 자기 노드의 실시간 상태를 기준으로 한 번 더 검증합니다. 이 검증 로직들의 집합이 Admit Handler들입니다.
// NewMainKubelet instantiates a new Kubelet object along with all the required internal modules.
// No initialization of Kubelet and its modules should happen here.
func NewMainKubelet(kubeCfg *kubeletconfiginternal.KubeletConfiguration,
    kubeDeps *Dependencies,
    crOptions *config.ContainerRuntimeOptions,
    hostname string,
    hostnameOverridden bool,
    nodeName types.NodeName,
    nodeIPs []net.IP,
    providerID string,
    cloudProvider string,
    certDirectory string,
    rootDirectory string,
    podLogsDirectory string,
    imageCredentialProviderConfigFile string,
    imageCredentialProviderBinDir string,
    registerNode bool,
    registerWithTaints []v1.Taint,
    allowedUnsafeSysctls []string,
    experimentalMounterPath string,
    kernelMemcgNotification bool,
    experimentalNodeAllocatableIgnoreEvictionThreshold bool,
    minimumGCAge metav1.Duration,
    maxPerPodContainerCount int32,
    maxContainerCount int32,
    registerSchedulable bool,
    keepTerminatedPodVolumes bool,
    nodeLabels map[string]string,
    nodeStatusMaxImages int32,
    seccompDefault bool,
) (*Kubelet, error) {
    ctx := context.Background()
    logger := klog.TODO()

    ...

    // setup eviction manager
    evictionManager, evictionAdmitHandler := eviction.NewManager(klet.resourceAnalyzer, evictionConfig,
        killPodNow(klet.podWorkers, kubeDeps.Recorder), klet.imageManager, klet.containerGC, kubeDeps.Recorder, nodeRef, klet.clock, kubeCfg.LocalStorageCapacityIsolation)

    klet.evictionManager = evictionManager
    klet.admitHandlers.AddPodAdmitHandler(evictionAdmitHandler)

    // Safe, allowed sysctls can always be used as unsafe sysctls in the spec.
    // Hence, we concatenate those two lists.
    safeAndUnsafeSysctls := append(sysctl.SafeSysctlAllowlist(), allowedUnsafeSysctls...)
    sysctlsAllowlist, err := sysctl.NewAllowlist(safeAndUnsafeSysctls)
    if err != nil {
        return nil, err
    }
    klet.admitHandlers.AddPodAdmitHandler(sysctlsAllowlist)

    // enable active deadline handler
    activeDeadlineHandler, err := newActiveDeadlineHandler(klet.statusManager, kubeDeps.Recorder, klet.clock)
    if err != nil {
        return nil, err
    }
    klet.AddPodSyncLoopHandler(activeDeadlineHandler)
    klet.AddPodSyncHandler(activeDeadlineHandler)

    klet.admitHandlers.AddPodAdmitHandler(klet.containerManager.GetAllocateResourcesPodAdmitHandler())

    criticalPodAdmissionHandler := preemption.NewCriticalPodAdmissionHandler(klet.GetActivePods, killPodNow(klet.podWorkers, kubeDeps.Recorder), kubeDeps.Recorder)
    klet.admitHandlers.AddPodAdmitHandler(lifecycle.NewPredicateAdmitHandler(klet.getNodeAnyWay, criticalPodAdmissionHandler, klet.containerManager.UpdatePluginResources))
    // apply functional Option's
    for _, opt := range kubeDeps.Options {
        opt(klet)
    }

    if sysruntime.GOOS == "linux" {
        // AppArmor is a Linux kernel security module and it does not support other operating systems.
        klet.appArmorValidator = apparmor.NewValidator()
        klet.softAdmitHandlers.AddPodAdmitHandler(lifecycle.NewAppArmorAdmitHandler(klet.appArmorValidator))
    }

    leaseDuration := time.Duration(kubeCfg.NodeLeaseDurationSeconds) * time.Second
    renewInterval := time.Duration(float64(leaseDuration) * nodeLeaseRenewIntervalFraction)
    klet.nodeLeaseController = lease.NewController(
        klet.clock,
        klet.heartbeatClient,
        string(klet.nodeName),
        kubeCfg.NodeLeaseDurationSeconds,
        klet.onRepeatedHeartbeatFailure,
        renewInterval,
        string(klet.nodeName),
        v1.NamespaceNodeLease,
        util.SetNodeOwnerFunc(klet.heartbeatClient, string(klet.nodeName)))

    // setup node shutdown manager
    shutdownManager, shutdownAdmitHandler := nodeshutdown.NewManager(&nodeshutdown.Config{
        Logger:                           logger,
        ProbeManager:                     klet.probeManager,
        Recorder:                         kubeDeps.Recorder,
        NodeRef:                          nodeRef,
        GetPodsFunc:                      klet.GetActivePods,
        KillPodFunc:                      killPodNow(klet.podWorkers, kubeDeps.Recorder),
        SyncNodeStatusFunc:               klet.syncNodeStatus,
        ShutdownGracePeriodRequested:     kubeCfg.ShutdownGracePeriod.Duration,
        ShutdownGracePeriodCriticalPods:  kubeCfg.ShutdownGracePeriodCriticalPods.Duration,
        ShutdownGracePeriodByPodPriority: kubeCfg.ShutdownGracePeriodByPodPriority,
        StateDirectory:                   rootDirectory,
    })
    klet.shutdownManager = shutdownManager
    klet.usernsManager, err = userns.MakeUserNsManager(klet)
    if err != nil {
        return nil, fmt.Errorf("create user namespace manager: %w", err)
    }
    klet.admitHandlers.AddPodAdmitHandler(shutdownAdmitHandler)

    // Finally, put the most recent version of the config on the Kubelet, so
    // people can see how it was configured.
    klet.kubeletConfiguration = *kubeCfg

    // Generating the status funcs should be the last thing we do,
    // since this relies on the rest of the Kubelet having been constructed.
    klet.setNodeStatusFuncs = klet.defaultNodeStatusFuncs()

    return klet, nil
}
각 Handler에 대한 설명은 아래와 같습니다.
| 순서 | 등록 코드 | Admit Handler | 실제 구현체 | 역할 |
|---|---|---|---|---|
| 1 | admitHandlers.AddPodAdmitHandler(evictionAdmitHandler) |
Eviction Manager | eviction.NewManager()가 반환하는 admit handler |
노드가 메모리/디스크 등 자원 압박(pressure) 상태일 때 신규 파드 거부 |
| 2 | admitHandlers.AddPodAdmitHandler(sysctlsAllowlist) |
Sysctl Allowlist | sysctl.NewAllowlist() |
파드가 지정한 sysctl이 허용 목록(safe+unsafe) 안에 있는지 검사, 아니면 거부 |
| 3 | admitHandlers.AddPodAdmitHandler(klet.containerManager.GetAllocateResourcesPodAdmitHandler()) |
Topology Manager | containerManagerImpl.GetAllocateResourcesPodAdmitHandler() → return cm.topologyManager |
Topology Manager가 CPU/Memory/Device Manager로부터 각각 NUMA 힌트를 모아 정렬 가능 여부 판단 + 가능하면 각 매니저의 Allocate() 호출해 실제 리소스 예약까지 확정 |
| 4 | admitHandlers.AddPodAdmitHandler(lifecycle.NewPredicateAdmitHandler(klet.getNodeAnyWay, criticalPodAdmissionHandler, klet.containerManager.UpdatePluginResources)) |
Predicate Admit Handler (내부에 Critical Pod Admission/Preemption 포함) |
lifecycle.NewPredicateAdmitHandler() |
노드 조건(NodeSelector, 포트 충돌, 리소스 fit 등) 재검증. 부족하면 criticalPodAdmissionHandler가 우선순위 낮은 파드를 선점(evict) 시도 |
| 5 | admitHandlers.AddPodAdmitHandler(shutdownAdmitHandler) |
Node Shutdown Manager | nodeshutdown.NewManager()가 반환하는 admit handler |
노드가 종료 절차 중일 때 신규 파드 거부 |
| (조건부, Linux 전용) | softAdmitHandlers.AddPodAdmitHandler(lifecycle.NewAppArmorAdmitHandler(...)) |
AppArmor Admit Handler | lifecycle.NewAppArmorAdmitHandler() |
AppArmor 프로파일 검증. **별도 리스트(softAdmitHandlers)**에 등록 |
| (별도 그룹, Admit 아님) | AddPodSyncLoopHandler / AddPodSyncHandler |
Active Deadline Handler | newActiveDeadlineHandler() |
실행 시간 초과된 기존 파드를 감시 후 강제 종료 — 진입(admission)이 아니라 지속 감시라서 Admit Handler 목록에 없음 |
이렇게 모든 Handler의 승인을 받게 되면 그 다음은 kl.podWorkers.UpdatePod를 호출해서 Pod의 상태를 업데이트해주게 됩니다.
여기서 우리가 집중해야하는 부분은 klet.containerManager.GetAllocateResourcesPodAdmitHandler())을 통해 등록되는 Topology Manager 입니다. 이 Topology Manager에서는 CPU/Memory/Device Manager로부터 각각 NUMA 힌트를 모아 정렬 가능 여부 판단한 뒤 가능하면 각 매니저의 Allocate() 호출해 실제 리소스 예약까지 확정합니다.
Kubernetes에서 NUMA 노드 고정하기
앞서 발표 내용을 정리하면서 Kubernetes에서 CPU Pinning을 지원한다고 했습니다. 이러한 기능을 구현하고 있는 것이 위에서 언급한 containerManager 통합 핸들러의 CPU Manager입니다.
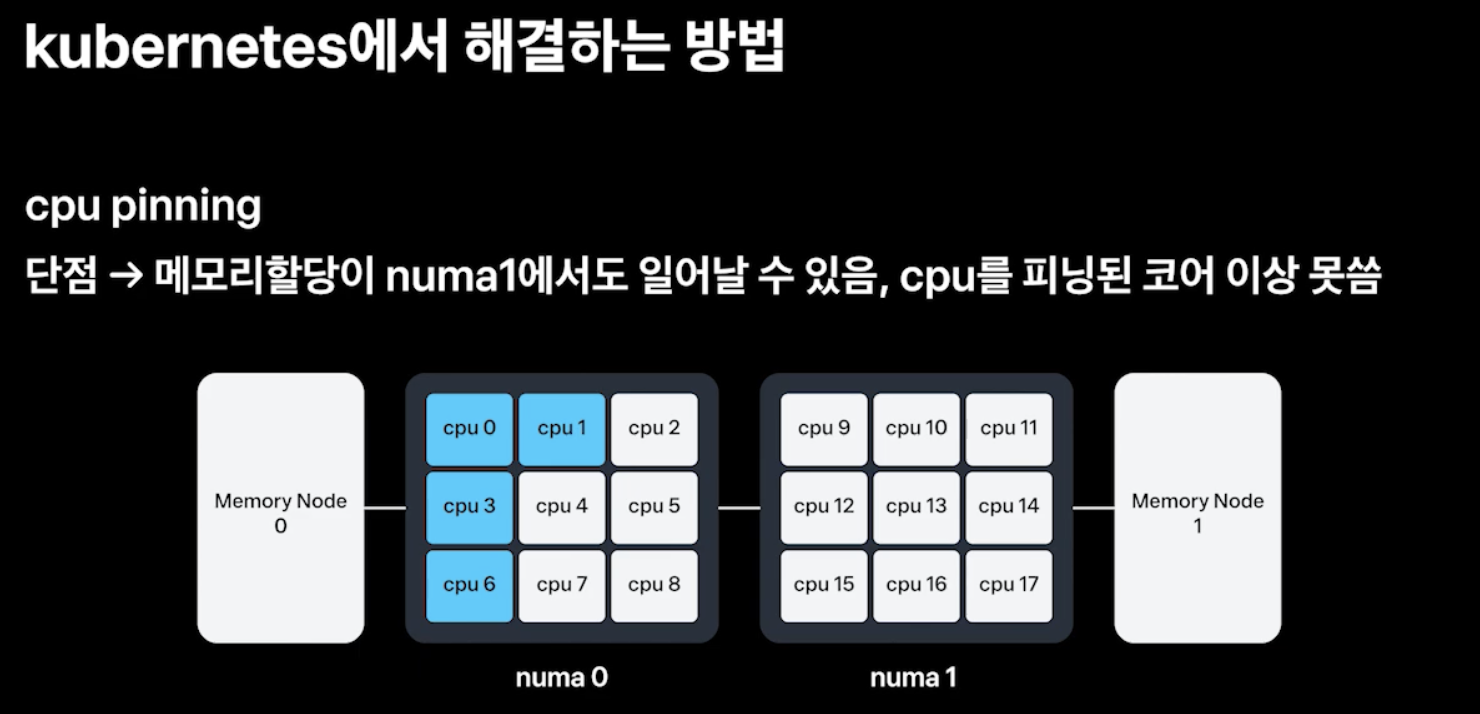
CPU Manager의 기본 정책은 none이지만, static으로 설정하면 QoS가 Guaranteed(즉, request == limit)이면서 정수 코어를 요청한 Pod에 대해서 CPU 코어가 요청한 만큼 배타적 할당(dedicated) 됩니다.2
kubelet을 설정하는 config에 아래와 같이 cpuManagerPolicy을 static으로 설정하면 적용됩니다.
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
cpuManagerPolicy: static
cpuManagerReconcilePeriod: 10s
systemReserved:
  cpu: "1"
kubeReserved:
  cpu: "1"
마찬가지로 Memory Pinnig 역시 Memory Manager에 의해 구현되어 있습니다.
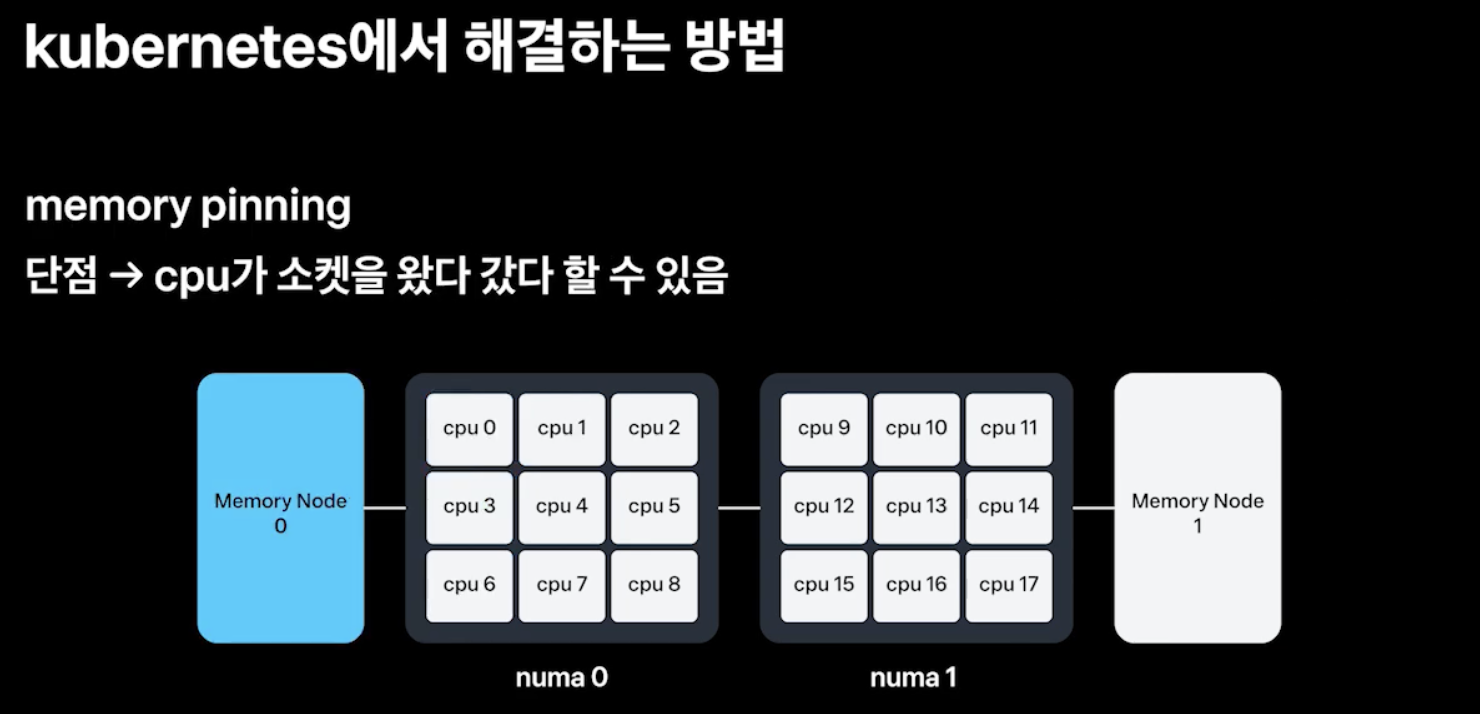
Memory Manager의 기본 정책도 none이고, static으로 설정하면 QoS가 Guaranteed(즉, request == limit)인 Pod에 대해 요청한 만큼 메모리가 예약 됩니다.
kubelet을 설정하는 config에 아래와 같이 memoryManagerPolicy를 static으로 설정하면 적용됩니다.3
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
memoryManagerPolicy: Static
systemReserved:
  memory: "2Gi"
kubeReserved:
  memory: "1Gi"
reservedMemory:
  - numaNode: 0
    limits:
      memory: "1586Mi"
  - numaNode: 1
    limits:
      memory: "1586Mi"
발표 내용에서도 언급하고 있듯이,
- CPU pinning만 하게 되면 메모리 노드 여유에 따라 프로세스의 메모리가 이동하므로 remote access가 일어납니다
- Memory pinning만 하게 되면 CPU 여유에 따라 프로세스를 실행하는 CPU가 이동하므로 remote access가 일어납니다
따라서 NUMA 아키텍처를 고려해서 최적화하기 위해선 CPU, Memory를 같은 NUMA 노드 단위로 배치해야하고 이를 구현한 정책이 Topology Manager의 single-numa-node 정책입니다.4
single-numa-node 정책을 적용하기 위해선 cpuManager 정책을 static으로 memoryManager 정책을 Static으로 설정해주어야 합니다.
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
memoryManagerPolicy: Static
cpuManagerPolicy: static
topologyManagerPolicy: single-numa-node
systemReserved:
  memory: "2Gi"
kubeReserved:
  memory: "1Gi"
reservedMemory:
  - numaNode: 0
    limits:
      memory: "1586Mi"
  - numaNode: 1
    limits:
      memory: "1586Mi"
때문에 single-numa-node 정책을 적용하기 위해서 Pod는
- QoS가 Guaranteed(즉, request == limit)이면서
- 정수 코어를 요청해야합니다
위 정책을 통해 프로세스의 CPU를 특정 NUMA 노드 코어에 전용 할당하고 메모리를 그 같은 노드에서 할당합니다. 이때 위 둘이 같은 NUMA 노드가 안 되면 파드 자체를 거부(Admission 실패)하게 됩니다.
여기까지 보면 앞에서 정리한 문제 정의를 해결할 수 있을 것 같습니다. task가 실행되는 CPU, 메모리를 동일한 NUMA 노드로 고정할 수 있기 때문입니다.
하지만 남은 문제가 있습니다. 그건 바로 제약이 심하다는 것입니다. 일반적으로 Kubernetes 위에서 동작하는 Pod의 CPU Request가 항상 정수로 떨어지지 않습니다. 또한 QoS가 항상 Guaranteed 일 수 없습니다. 어떤 것은 Burstable 일 수 도 있기 때문입니다.
발표 내용에서도 이러한 점을 언급합니다. CPU 가 Spike 칠 수 도 있는데, 이렇게 고정된 값으로 제한하면 서비스가 불안정해질 수 있다고요. 그래서 토스에서 제시한 해결책은 **"kubelet을 커스텀하는 것"**입니다.
Kubelet 커스텀 목표 설정
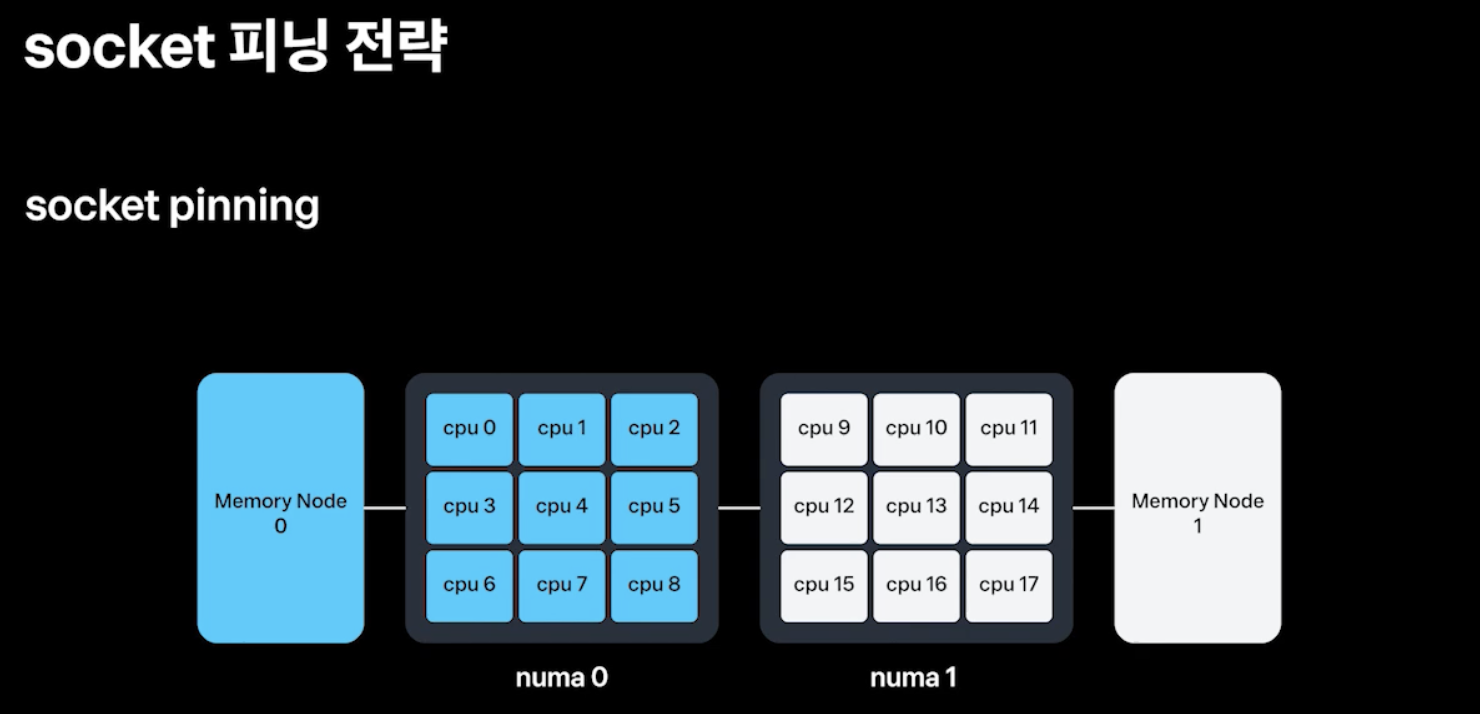
kubelet을 커스텀을 통해 구현해야 하는 동작은 아래와 같습니다.
- task가 실행되는 CPU, 메모리를 동일한 NUMA 노드로 고정한다
- 특정 코어 수나 메모리로 제한하지 않고, 소켓 전체 범위로 할당한다
- Pod의 QoS는 Guaranteed 뿐만아니라 Burstable도 수용 가능해야한다
- 코어 수를 요청할 때 정수가 아니여도 동작해야한다
이제 위 동작을 구현하기 위해 kubelet에서 어떤 코드를 추가하고 수정하면 되는 지 분석해보겠습니다.
Topology Manager
우리는 syncLoop에서 각 핸들러마다 podAdmitHandler.Admit를 호출한다는 것을 알아봤습니다. 그리고 podAdmitHandler 중 우리가 집중에서 볼 핸들러는 Topology Manager는
klet.containerManager.GetAllocateResourcesPodAdmitHandler())을 통해 등록됩니다.
klet.containerManager.GetAllocateResourcesPodAdmitHandler())은 pkg/kubelet/cm/container_manager_linux.go 파일에서 구현되어 있고 cm.topologyManager를 반환합니다.
func (cm *containerManagerImpl) GetAllocateResourcesPodAdmitHandler() lifecycle.PodAdmitHandler {
    return cm.topologyManager
}
cm.topologyManager가 반환하는 것은 topologymanager.Manager (=topologymanger 패키지의 Manager 인터페이스)입니다.
type containerManagerImpl struct {
    sync.RWMutex
    cadvisorInterface cadvisor.Interface
    mountUtil         mount.Interface
    NodeConfig
    status Status
    // External containers being managed.
    systemContainers []*systemContainer
    // Tasks that are run periodically
    periodicTasks []func()
    // Holds all the mounted cgroup subsystems
    subsystems *CgroupSubsystems
    nodeInfo   *v1.Node
    // Interface for cgroup management
    cgroupManager CgroupManager
    // Capacity of this node.
    capacity v1.ResourceList
    // Capacity of this node, including internal resources.
    internalCapacity v1.ResourceList
    // Absolute cgroupfs path to a cgroup that Kubelet needs to place all pods under.
    // This path include a top level container for enforcing Node Allocatable.
    cgroupRoot CgroupName
    // Event recorder interface.
    recorder record.EventRecorder
    // Interface for QoS cgroup management
    qosContainerManager QOSContainerManager
    // Interface for exporting and allocating devices reported by device plugins.
    deviceManager devicemanager.Manager
    // Interface for CPU affinity management.
    cpuManager cpumanager.Manager
    // Interface for memory affinity management.
    memoryManager memorymanager.Manager
    // Interface for Topology resource co-ordination
    topologyManager topologymanager.Manager
    // Interface for Dynamic Resource Allocation management.
    draManager dra.Manager
}
위에서 GetAllocateResourcesPodAdmitHandler() 함수의 반환 값은 lifecycle.PodAdmitHandler이었습니다. 아래 Manager 인터페이스는 lifecycle.PodAdmitHandler 인터페이스를 임베딩하고 있기 때문에 Manager의 메서드 집합은 PodAdmitHandler의 메서드 집합을 포함합니다. 따라서 Manager가 lifecycle.PodAdmitHandler 인터페이스 형태로 반환될 수 있었 던 것입니다.
// Manager interface provides methods for Kubelet to manage pod topology hints
type Manager interface {
    // PodAdmitHandler is implemented by Manager
    lifecycle.PodAdmitHandler
    // AddHintProvider adds a hint provider to manager to indicate the hint provider
    // wants to be consulted with when making topology hints
    AddHintProvider(HintProvider)
    // AddContainer adds pod to Manager for tracking
    AddContainer(pod *v1.Pod, container *v1.Container, containerID string)
    // RemoveContainer removes pod from Manager tracking
    RemoveContainer(containerID string) error
    // Store is the interface for storing pod topology hints
    Store
}

type manager struct {
    //Topology Manager Scope
    scope Scope
}

...

func (m *manager) GetAffinity(podUID string, containerName string) TopologyHint {
    return m.scope.GetAffinity(podUID, containerName)
}

func (m *manager) GetPolicy() Policy {
    return m.scope.GetPolicy()
}

func (m *manager) AddHintProvider(h HintProvider) {
    m.scope.AddHintProvider(h)
}

func (m *manager) AddContainer(pod *v1.Pod, container *v1.Container, containerID string) {
    m.scope.AddContainer(pod, container, containerID)
}

func (m *manager) RemoveContainer(containerID string) error {
    return m.scope.RemoveContainer(containerID)
}

func (m *manager) Admit(attrs *lifecycle.PodAdmitAttributes) lifecycle.PodAdmitResult {
    klog.InfoS("Topology Admit Handler", "podUID", attrs.Pod.UID, "podNamespace", attrs.Pod.Namespace, "podName", attrs.Pod.Name)
    metrics.TopologyManagerAdmissionRequestsTotal.Inc()

    startTime := time.Now()
    podAdmitResult := m.scope.Admit(attrs.Pod)
    metrics.TopologyManagerAdmissionDuration.Observe(float64(time.Since(startTime).Milliseconds()))

    return podAdmitResult
}
Manager 인터페이스는 *manager를 리시버로 각 메서드가 구현되는 것을 확인할 수 있고 Scope의 Wrapper에 불과하다는 것을 확인할 수 있습니다.
pkg/kubelet/lifecycle/interfaces.go에서 정의된 PodAdmitHandler 인터페이스를 보면
Admit을 구현해야함을 알 수 있습니다. manager에서는 Admit을 포함한 GetAffinity, GetPolicy, AddHintProvider, AddContainer, RemoveContainer 총 6개의 메서드를 구현하고 있습니다.
// PodAdmitHandler is notified during pod admission.
type PodAdmitHandler interface {
    // Admit evaluates if a pod can be admitted.
    Admit(attrs *PodAdmitAttributes) PodAdmitResult
}
이제 Admit 구현이 어떻게 되어 있는 지 확인해보면 pkg/kubelet/cm/topologymanager/topology_manager.go에서 아래와 같이 구현되어 있습니다.
func (m *manager) Admit(attrs *lifecycle.PodAdmitAttributes) lifecycle.PodAdmitResult {
    klog.InfoS("Topology Admit Handler", "podUID", attrs.Pod.UID, "podNamespace", attrs.Pod.Namespace, "podName", attrs.Pod.Name)
    metrics.TopologyManagerAdmissionRequestsTotal.Inc()

    startTime := time.Now()
    podAdmitResult := m.scope.Admit(attrs.Pod)
    metrics.TopologyManagerAdmissionDuration.Observe(float64(time.Since(startTime).Milliseconds()))

    return podAdmitResult
}
결국 내부적으로 m.scope.Admit(attrs.Pod)를 호출해서 실제 Admit을 수행하는 것으로 확인되었습니다.
scope.Admit은 어떤 동작을 수행하는 지 알아보기 위해 pkg/kubelet/cm/topologymanager/scope.go에 정의된 Scope 인터페이스를 확인해보겠습니다.
// Scope interface for Topology Manager
type Scope interface {
    Name() string
    GetPolicy() Policy
    Admit(pod *v1.Pod) lifecycle.PodAdmitResult
    // AddHintProvider adds a hint provider to manager to indicate the hint provider
    // wants to be consoluted with when making topology hints
    AddHintProvider(h HintProvider)
    // AddContainer adds pod to Manager for tracking
    AddContainer(pod *v1.Pod, container *v1.Container, containerID string)
    // RemoveContainer removes pod from Manager tracking
    RemoveContainer(containerID string) error
    // Store is the interface for storing pod topology hints
    Store
}

type scope struct {
    mutex sync.Mutex
    name  string
    // Mapping of a Pods mapping of Containers and their TopologyHints
    // Indexed by PodUID to ContainerName
    podTopologyHints podTopologyHints
    // The list of components registered with the Manager
    hintProviders []HintProvider
    // Topology Manager Policy
    policy Policy
    // Mapping of (PodUid, ContainerName) to ContainerID for Adding/Removing Pods from PodTopologyHints mapping
    podMap containermap.ContainerMap
}

func (s *scope) Name() string {
    return s.name
}

func (s *scope) getTopologyHints(podUID string, containerName string) TopologyHint {
    s.mutex.Lock()
    defer s.mutex.Unlock()
    return s.podTopologyHints[podUID][containerName]
}

func (s *scope) setTopologyHints(podUID string, containerName string, th TopologyHint) {
    s.mutex.Lock()
    defer s.mutex.Unlock()

    if s.podTopologyHints[podUID] == nil {
        s.podTopologyHints[podUID] = make(map[string]TopologyHint)
    }
    s.podTopologyHints[podUID][containerName] = th
}

func (s *scope) GetAffinity(podUID string, containerName string) TopologyHint {
    return s.getTopologyHints(podUID, containerName)
}

func (s *scope) GetPolicy() Policy {
    return s.policy
}

func (s *scope) AddHintProvider(h HintProvider) {
    s.hintProviders = append(s.hintProviders, h)
}

// It would be better to implement this function in topologymanager instead of scope
// but topologymanager do not track mapping anymore
func (s *scope) AddContainer(pod *v1.Pod, container *v1.Container, containerID string) {
    s.mutex.Lock()
    defer s.mutex.Unlock()

    s.podMap.Add(string(pod.UID), container.Name, containerID)
}

// It would be better to implement this function in topologymanager instead of scope
// but topologymanager do not track mapping anymore
func (s *scope) RemoveContainer(containerID string) error {
    s.mutex.Lock()
    defer s.mutex.Unlock()

    klog.InfoS("RemoveContainer", "containerID", containerID)
    // Get the podUID and containerName associated with the containerID to be removed and remove it
    podUIDString, containerName, err := s.podMap.GetContainerRef(containerID)
    if err != nil {
        return nil
    }
    s.podMap.RemoveByContainerID(containerID)

    // In cases where a container has been restarted, it's possible that the same podUID and
    // containerName are already associated with a *different* containerID now. Only remove
    // the TopologyHints associated with that podUID and containerName if this is not true
    if _, err := s.podMap.GetContainerID(podUIDString, containerName); err != nil {
        delete(s.podTopologyHints[podUIDString], containerName)
        if len(s.podTopologyHints[podUIDString]) == 0 {
            delete(s.podTopologyHints, podUIDString)
        }
    }

    return nil
}
Scope 인터페이스는 Topology Manager를 위한 인터페이스이며 마찬가지로 Admit을 구현해야합니다. 그리고 Scope 인터페이스는 마찬가지로 *scope를 통해 메서드로 구현됩니다.
그런데 이상한 점이 하나 있습니다. 그건 바로 Admit이 정의되어 있지 않다는 점입니다. 그 이유는 scope는 공통 메서드만 정의하고 실제 Admit이나 GetAffinity는 containerScope이나 podScope에서 정의되기 때문입니다. 이를 위해 각 구현체에서는 scope를 임베딩합니다.
| 메서드 | 정의 위치 |
|---|---|
Name |
scope |
GetPolicy |
scope |
AddHintProvider |
scope |
AddContainer |
scope |
RemoveContainer |
scope |
GetAffinity |
scope에서 정의되지만 각 구현체에서 재정의됨 |
Admit |
각 구현체 |
type containerScope struct {
    scope
}

// Ensure containerScope implements Scope interface
var _ Scope = &containerScope{}

// NewContainerScope returns a container scope.
func NewContainerScope(policy Policy) Scope {
    return &containerScope{
        scope{
            name:             containerTopologyScope,
            podTopologyHints: podTopologyHints{},
            policy:           policy,
            podMap:           containermap.NewContainerMap(),
        },
    }
}

func (s *containerScope) Admit(pod *v1.Pod) lifecycle.PodAdmitResult {
    for _, container := range append(pod.Spec.InitContainers, pod.Spec.Containers...) {
        bestHint, admit := s.calculateAffinity(pod, &container)
        klog.InfoS("Best TopologyHint", "bestHint", bestHint, "pod", klog.KObj(pod), "containerName", container.Name)

        if !admit {
            metrics.TopologyManagerAdmissionErrorsTotal.Inc()
            return admission.GetPodAdmitResult(&TopologyAffinityError{})
        }
        klog.InfoS("Topology Affinity", "bestHint", bestHint, "pod", klog.KObj(pod), "containerName", container.Name)
        s.setTopologyHints(string(pod.UID), container.Name, bestHint)

        err := s.allocateAlignedResources(pod, &container)
        if err != nil {
            metrics.TopologyManagerAdmissionErrorsTotal.Inc()
            return admission.GetPodAdmitResult(err)
        }
    }
    return admission.GetPodAdmitResult(nil)
}

func (s *containerScope) accumulateProvidersHints(pod *v1.Pod, container *v1.Container) []map[string][]TopologyHint {
    var providersHints []map[string][]TopologyHint

    for _, provider := range s.hintProviders {
        // Get the TopologyHints for a Container from a provider.
        hints := provider.GetTopologyHints(pod, container)
        providersHints = append(providersHints, hints)
        klog.InfoS("TopologyHints", "hints", hints, "pod", klog.KObj(pod), "containerName", container.Name)
    }
    return providersHints
}

func (s *containerScope) calculateAffinity(pod *v1.Pod, container *v1.Container) (TopologyHint, bool) {
    providersHints := s.accumulateProvidersHints(pod, container)
    bestHint, admit := s.policy.Merge(providersHints)
    klog.InfoS("ContainerTopologyHint", "bestHint", bestHint)
    return bestHint, admit
}
type podScope struct {
    scope
}

// Ensure podScope implements Scope interface
var _ Scope = &podScope{}

// NewPodScope returns a pod scope.
func NewPodScope(policy Policy) Scope {
    return &podScope{
        scope{
            name:             podTopologyScope,
            podTopologyHints: podTopologyHints{},
            policy:           policy,
            podMap:           containermap.NewContainerMap(),
        },
    }
}

func (s *podScope) Admit(pod *v1.Pod) lifecycle.PodAdmitResult {
    bestHint, admit := s.calculateAffinity(pod)
    klog.InfoS("Best TopologyHint", "bestHint", bestHint, "pod", klog.KObj(pod))
    if !admit {
        metrics.TopologyManagerAdmissionErrorsTotal.Inc()
        return admission.GetPodAdmitResult(&TopologyAffinityError{})
    }

    for _, container := range append(pod.Spec.InitContainers, pod.Spec.Containers...) {
        klog.InfoS("Topology Affinity", "bestHint", bestHint, "pod", klog.KObj(pod), "containerName", container.Name)
        s.setTopologyHints(string(pod.UID), container.Name, bestHint)

        err := s.allocateAlignedResources(pod, &container)
        if err != nil {
            metrics.TopologyManagerAdmissionErrorsTotal.Inc()
            return admission.GetPodAdmitResult(err)
        }
    }
    return admission.GetPodAdmitResult(nil)
}

func (s *podScope) accumulateProvidersHints(pod *v1.Pod) []map[string][]TopologyHint {
    var providersHints []map[string][]TopologyHint

    for _, provider := range s.hintProviders {
        // Get the TopologyHints for a Pod from a provider.
        hints := provider.GetPodTopologyHints(pod)
        providersHints = append(providersHints, hints)
        klog.InfoS("TopologyHints", "hints", hints, "pod", klog.KObj(pod))
    }
    return providersHints
}

func (s *podScope) calculateAffinity(pod *v1.Pod) (TopologyHint, bool) {
    providersHints := s.accumulateProvidersHints(pod)
    bestHint, admit := s.policy.Merge(providersHints)
    klog.InfoS("PodTopologyHint", "bestHint", bestHint)
    return bestHint, admit
}
정리하면, Topology Manager는 scope와 policy 두 가지 축으로 구성되고, scope는 containerScope/podScope로 나뉩니다. 그리고 각 scope에는 policy가 설정됩니다. scope의 기본 값은 containerScope입니다.
Admit 과정에서 calculateAffinity을 호출하여 hintProviders에 등록된 CPU/Memory/Device Manager로부터 각각 NUMA 힌트를 취합합니다. 이후 s.policy.Merge(providersHints)를 호출하여 설정한 정책에 맞게 정렬 가능 여부 판단한 뒤 가능하면 allocateAlignedResources를 통해 각 매니저의 Allocate() 호출해 실제 리소스 예약까지 확정합니다.
kubelet
  │
  ├─ Manager (interface)              ← kubelet이 보는 계약, PodAdmitHandler로 등록
  │
  └─ manager (struct)                 ← 얇은 래퍼. 메트릭/로깅만 하고 전부 위임
        │
        └─ scope Scope                ← ① 인터페이스 필드 (has-a)
             │
             ├─ *containerScope ┐
             └─ *podScope       ┘     ← 이 중 하나가 런타임에 주입됨
                    │
                    └─ scope          ← ② struct 임베딩 (is-a 흉내)
                         │
                         └─ policy Policy   ← ③ 또 인터페이스 필드 (has-a)
                              ├─ nonePolicy
                              ├─ bestEffortPolicy
                              ├─ restrictedPolicy
                              └─ singleNumaNodePolicy
HintProvider
hintProviders에 등록된 것들은 어떤 것들이 있을까요? 그리고 이것들은 언제 등록될까요? 이것은 kubelet이 시작될 때 pkg/kubelet/cm/container_manager_linux.go에 정의된 NewContainerManager을 호출할 때 등록됩니다.
아래 코드를 보면 cm.deviceManager, cm.cpuManager, cm.memoryManager가 등록되는 것을 알 수 있습니다.
func NewContainerManager(mountUtil mount.Interface, cadvisorInterface cadvisor.Interface, nodeConfig NodeConfig, failSwapOn bool, recorder record.EventRecorder, kubeClient clientset.Interface) (ContainerManager, error) {
    subsystems, err := GetCgroupSubsystems()
    ...

    cm := &containerManagerImpl{
        cadvisorInterface:   cadvisorInterface,
        mountUtil:           mountUtil,
        NodeConfig:          nodeConfig,
        subsystems:          subsystems,
        cgroupManager:       cgroupManager,
        capacity:            capacity,
        internalCapacity:    internalCapacity,
        cgroupRoot:          cgroupRoot,
        recorder:            recorder,
        qosContainerManager: qosContainerManager,
    }

    cm.topologyManager, err = topologymanager.NewManager(
        machineInfo.Topology,
        nodeConfig.TopologyManagerPolicy,
        nodeConfig.TopologyManagerScope,
        nodeConfig.TopologyManagerPolicyOptions,
    )

    if err != nil {
        return nil, err
    }

    klog.InfoS("Creating device plugin manager")
    cm.deviceManager, err = devicemanager.NewManagerImpl(machineInfo.Topology, cm.topologyManager)
    if err != nil {
        return nil, err
    }
    cm.topologyManager.AddHintProvider(cm.deviceManager)

    // initialize DRA manager
    if utilfeature.DefaultFeatureGate.Enabled(kubefeatures.DynamicResourceAllocation) {
        klog.InfoS("Creating Dynamic Resource Allocation (DRA) manager")
        cm.draManager, err = dra.NewManagerImpl(kubeClient, nodeConfig.KubeletRootDir, nodeConfig.NodeName)
        if err != nil {
            return nil, err
        }
    }

    // Initialize CPU manager
    cm.cpuManager, err = cpumanager.NewManager(
        nodeConfig.CPUManagerPolicy,
        nodeConfig.CPUManagerPolicyOptions,
        nodeConfig.CPUManagerReconcilePeriod,
        machineInfo,
        nodeConfig.NodeAllocatableConfig.ReservedSystemCPUs,
        cm.GetNodeAllocatableReservation(),
        nodeConfig.KubeletRootDir,
        cm.topologyManager,
    )
    if err != nil {
        klog.ErrorS(err, "Failed to initialize cpu manager")
        return nil, err
    }
    cm.topologyManager.AddHintProvider(cm.cpuManager)

    if utilfeature.DefaultFeatureGate.Enabled(kubefeatures.MemoryManager) {
        cm.memoryManager, err = memorymanager.NewManager(
            nodeConfig.ExperimentalMemoryManagerPolicy,
            machineInfo,
            cm.GetNodeAllocatableReservation(),
            nodeConfig.ExperimentalMemoryManagerReservedMemory,
            nodeConfig.KubeletRootDir,
            cm.topologyManager,
        )
        if err != nil {
            klog.ErrorS(err, "Failed to initialize memory manager")
            return nil, err
        }
        cm.topologyManager.AddHintProvider(cm.memoryManager)
    }

    return cm, nil
}
Overview
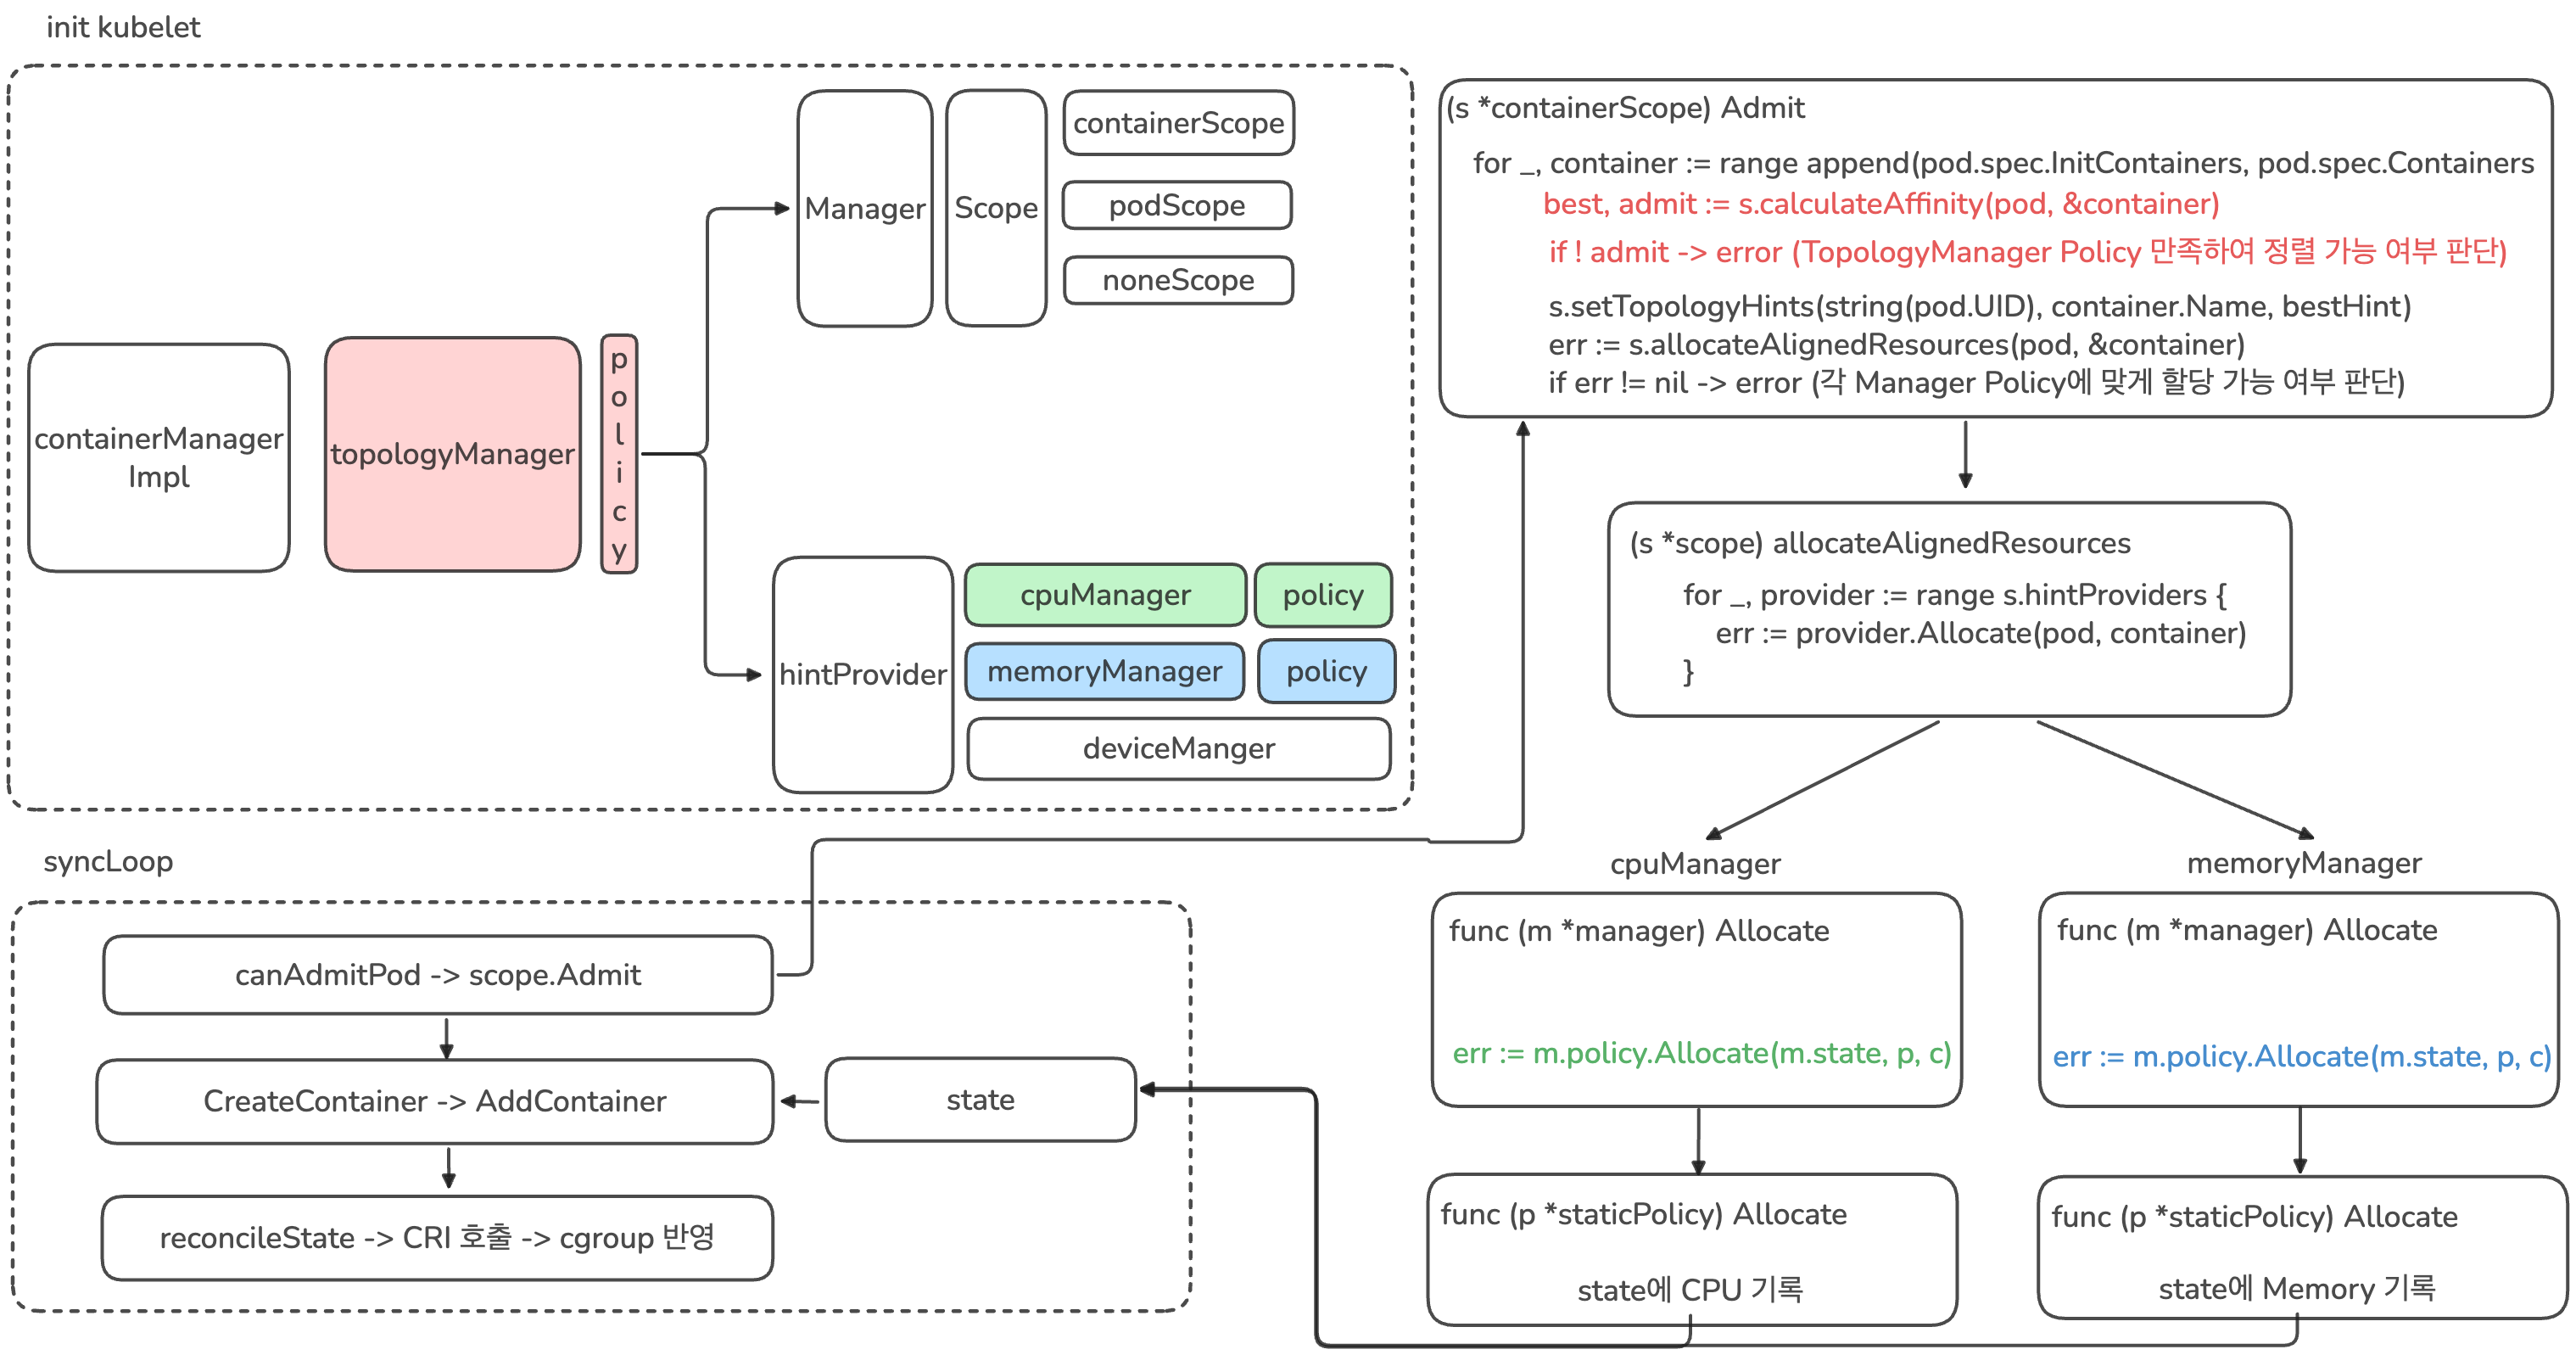
두 가지 단계로 정리해서 코드를 살펴보겠습니다.
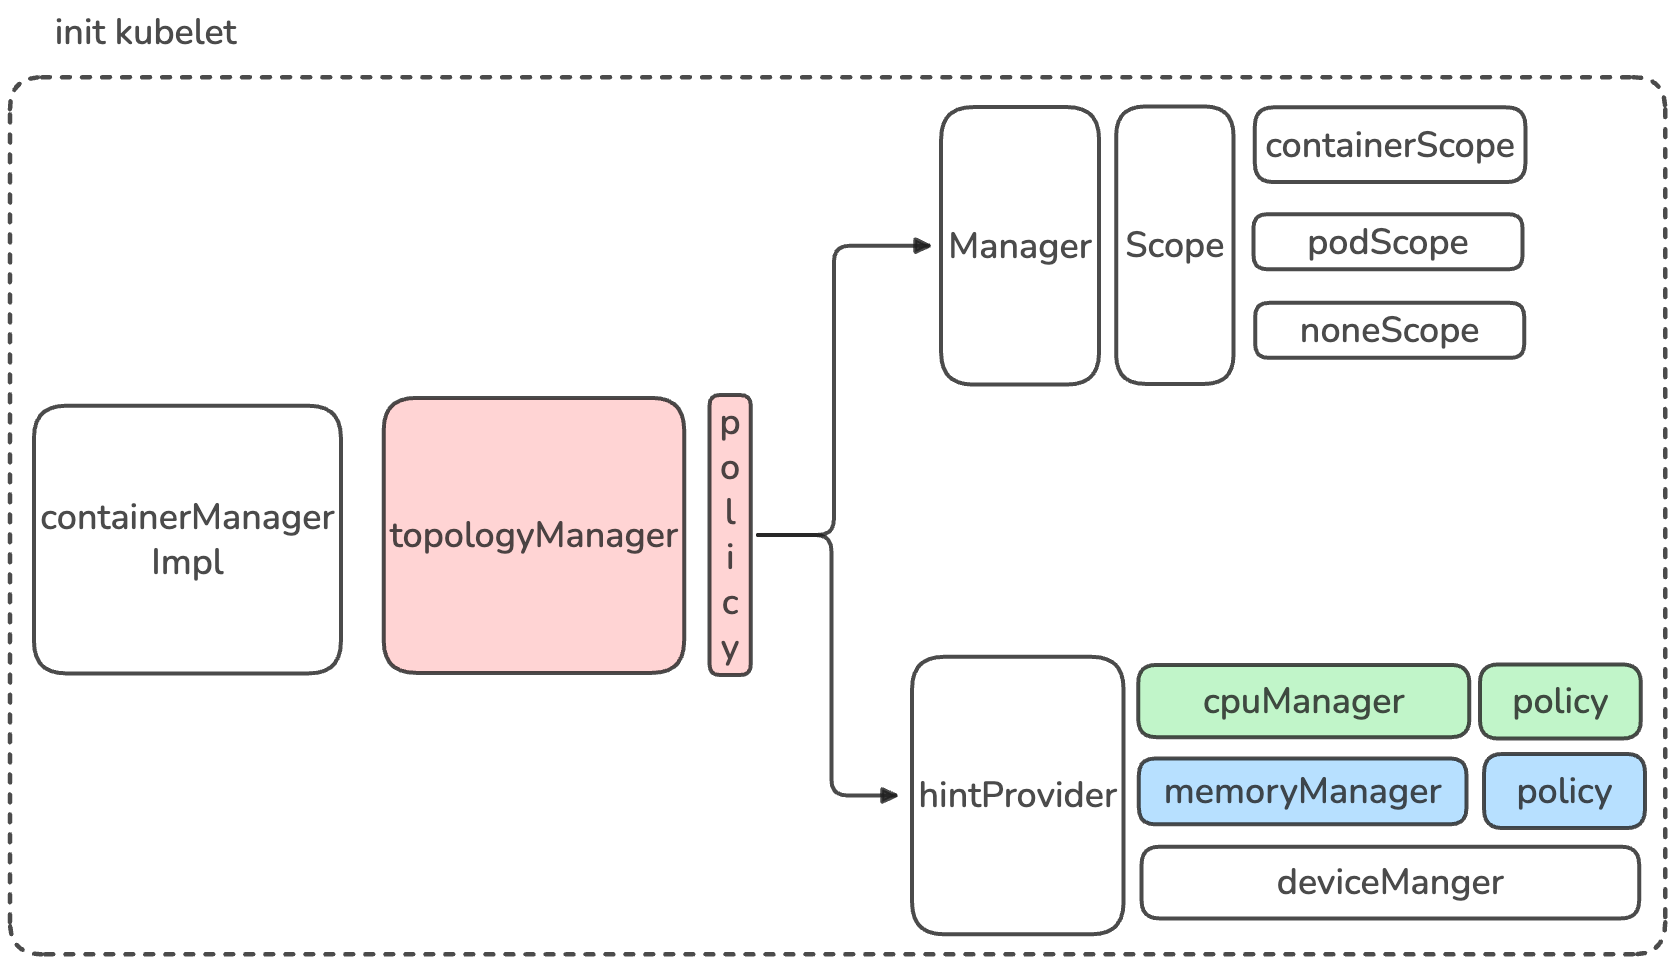
먼저, init kubelet입니다.
- 이 단계에서는 kubelet 관련 객체를 생성하고 초기화하면서 kubelet 구성 요소를 설정합니다.
- 이 때
containerManagerImpl이 생성되고topologyManager가TopologyManagerPolicy와 함께 생성됩니다. - 그 이후
cpuManager가CPUManagerPolicy와 함께 생성되고,memoryManager가MemoryManagerPolicy와 함께 생성되어topologyManager의 hintProvider로서 추가됩니다.
이 단계에서 기억해야 하는 것은 topologyManager, cpuManager, memoryManager 모두가 각자의 정책(policy)를 갖는다는 점입니다.
func NewContainerManager(mountUtil mount.Interface, cadvisorInterface cadvisor.Interface, nodeConfig NodeConfig, failSwapOn bool, recorder record.EventRecorder, kubeClient clientset.Interface) (ContainerManager, error) {
    ...

    cm := &containerManagerImpl{
        cadvisorInterface:   cadvisorInterface,
        mountUtil:           mountUtil,
        NodeConfig:          nodeConfig,
        subsystems:          subsystems,
        cgroupManager:       cgroupManager,
        capacity:            capacity,
        internalCapacity:    internalCapacity,
        cgroupRoot:          cgroupRoot,
        recorder:            recorder,
        qosContainerManager: qosContainerManager,
    }

    cm.topologyManager, err = topologymanager.NewManager(
        machineInfo.Topology,
        nodeConfig.TopologyManagerPolicy,
        nodeConfig.TopologyManagerScope,
        nodeConfig.TopologyManagerPolicyOptions,
    )

    if err != nil {
        return nil, err
    }

    klog.InfoS("Creating device plugin manager")
    cm.deviceManager, err = devicemanager.NewManagerImpl(machineInfo.Topology, cm.topologyManager)
    if err != nil {
        return nil, err
    }
    cm.topologyManager.AddHintProvider(cm.deviceManager)

    // Initialize CPU manager
    cm.cpuManager, err = cpumanager.NewManager(
        nodeConfig.CPUManagerPolicy,
        nodeConfig.CPUManagerPolicyOptions,
        nodeConfig.CPUManagerReconcilePeriod,
        machineInfo,
        nodeConfig.NodeAllocatableConfig.ReservedSystemCPUs,
        cm.GetNodeAllocatableReservation(),
        nodeConfig.KubeletRootDir,
        cm.topologyManager,
    )
    if err != nil {
        klog.ErrorS(err, "Failed to initialize cpu manager")
        return nil, err
    }
    cm.topologyManager.AddHintProvider(cm.cpuManager)

    if utilfeature.DefaultFeatureGate.Enabled(kubefeatures.MemoryManager) {
        cm.memoryManager, err = memorymanager.NewManager(
            nodeConfig.ExperimentalMemoryManagerPolicy,
            machineInfo,
            cm.GetNodeAllocatableReservation(),
            nodeConfig.ExperimentalMemoryManagerReservedMemory,
            nodeConfig.KubeletRootDir,
            cm.topologyManager,
        )
        if err != nil {
            klog.ErrorS(err, "Failed to initialize memory manager")
            return nil, err
        }
        cm.topologyManager.AddHintProvider(cm.memoryManager)
    }

    return cm, nil
}
추가로 Scope라는 것에 대해 알아볼 필요가 있습니다.
Scope는Manager인터페이스를 구현하는 구조체manager가 보유한 필드의 타입이며,- 그 필드에는 kubelet 기동 시 설정된 scope(containerScope / podScope / noneScope 중 하나)의 구현체 포인터가 담깁니다.
- topologyManagerScope 설정에 따라 선택된 containerScope, podScope, noneScope 중 하나가 담기며 기본 값은 containerScope입니다
// Manager interface provides methods for Kubelet to manage pod topology hints
type Manager interface {
    // PodAdmitHandler is implemented by Manager
    lifecycle.PodAdmitHandler
    // AddHintProvider adds a hint provider to manager to indicate the hint provider
    // wants to be consulted with when making topology hints
    AddHintProvider(HintProvider)
    // AddContainer adds pod to Manager for tracking
    AddContainer(pod *v1.Pod, container *v1.Container, containerID string)
    // RemoveContainer removes pod from Manager tracking
    RemoveContainer(containerID string) error
    // Store is the interface for storing pod topology hints
    Store
}

type manager struct {
    //Topology Manager Scope
    scope Scope
}

...

// NewManager creates a new TopologyManager based on provided policy and scope
func NewManager(topology []cadvisorapi.Node, topologyPolicyName string, topologyScopeName string, topologyPolicyOptions map[string]string) (Manager, error) {
    // When policy is none, the scope is not relevant, so we can short circuit here.
    if topologyPolicyName == PolicyNone {
        klog.InfoS("Creating topology manager with none policy")
        return &manager{scope: NewNoneScope()}, nil
    }

    opts, err := NewPolicyOptions(topologyPolicyOptions)
    if err != nil {
        return nil, err
    }

    klog.InfoS("Creating topology manager with policy per scope", "topologyPolicyName", topologyPolicyName, "topologyScopeName", topologyScopeName, "topologyPolicyOptions", opts)

    numaInfo, err := NewNUMAInfo(topology, opts)
    if err != nil {
        return nil, fmt.Errorf("cannot discover NUMA topology: %w", err)
    }

    if topologyPolicyName != PolicyNone && len(numaInfo.Nodes) > maxAllowableNUMANodes {
        return nil, fmt.Errorf("unsupported on machines with more than %v NUMA Nodes", maxAllowableNUMANodes)
    }

    var policy Policy
    switch topologyPolicyName {

    case PolicyBestEffort:
        policy = NewBestEffortPolicy(numaInfo, opts)

    case PolicyRestricted:
        policy = NewRestrictedPolicy(numaInfo, opts)

    case PolicySingleNumaNode:
        policy = NewSingleNumaNodePolicy(numaInfo, opts)

    default:
        return nil, fmt.Errorf("unknown policy: \"%s\"", topologyPolicyName)
    }

    var scope Scope
    switch topologyScopeName {

    case containerTopologyScope:
        scope = NewContainerScope(policy)

    case podTopologyScope:
        scope = NewPodScope(policy)

    default:
        return nil, fmt.Errorf("unknown scope: \"%s\"", topologyScopeName)
    }

    manager := &manager{
        scope: scope,
    }

    return manager, nil
}
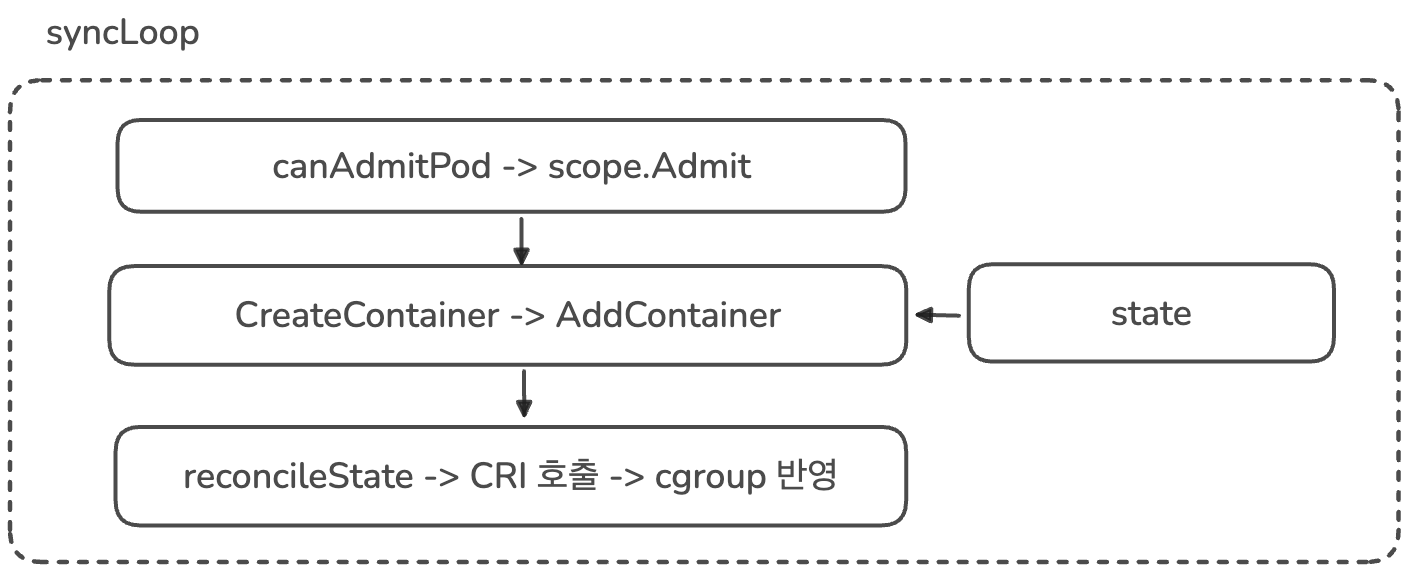
두번째는, syncLoop 단계입니다.
- 먼저 syncLoopIteration을 수행하면서, 추가할 Pod가 생기면 canAdmitPod를 호출해 이 Pod를 노드에 띄워도 되는 지 판단
- canAdmitPod는 내부적으로 scope.Admit을 호출하여 설정된 TopologyManager Scope 및 Policy에 맞게 배치 판단 (state에 저장)
- 배치 결과가 저장된 state 내용을 읽어서 container 생성 -> CRI 호출하여 cgroup 작성 마무리
이제 scope.Admit 단계를 더 자세히 알아보겠습니다. scope.Admit은 크게 두 가지 기능을 수행하는 데요
calculateAffinity를 통해 topologyManager policy에 맞게 topologyHint 계산allocateAlignedResources를 호출해 cpuManager, memoryManager의 각 policy에 맞게 리소스 할당
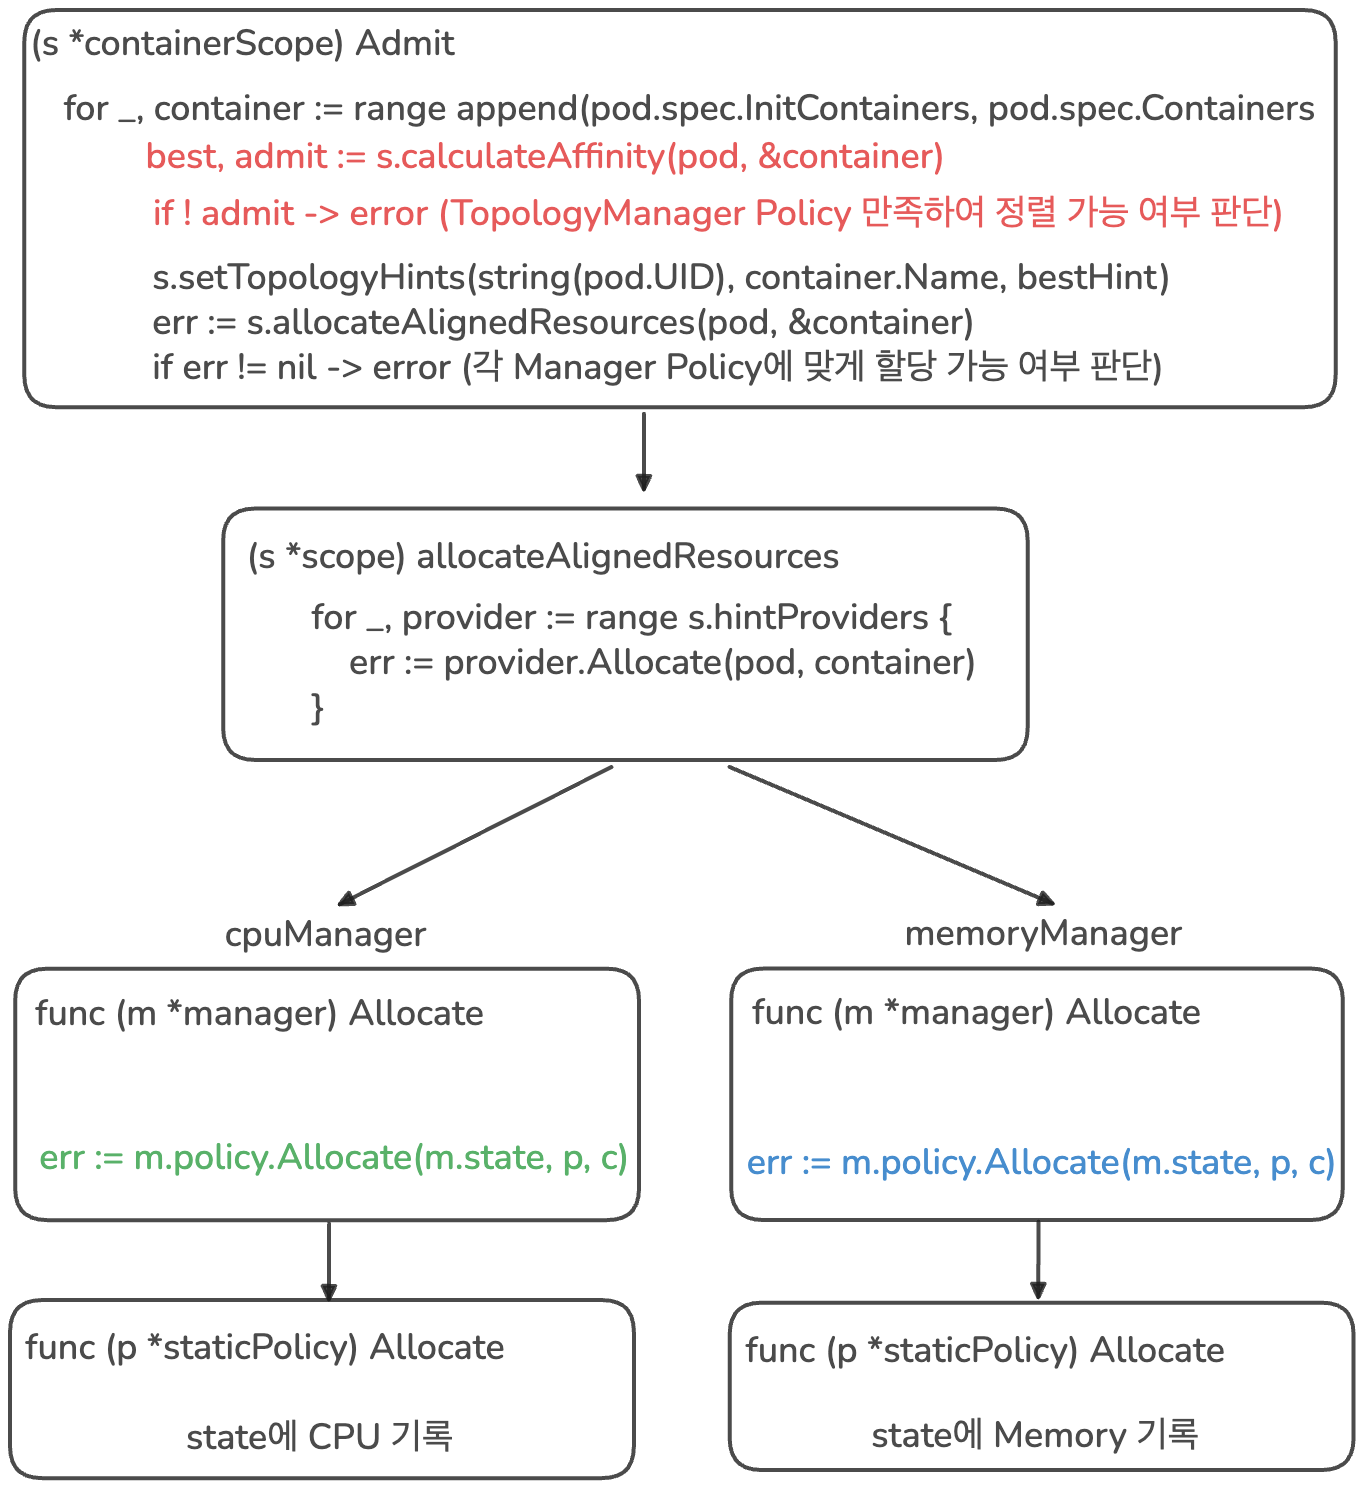
정리하면 Pod가 배치될 때 TopologManager에서 미리 hintProvider에 등록된 cpuManager, memoryManager, deviceManager를 통해 NUMA 관련된 topologyHint를 수집합니다.
그리고 수집된 힌트를 종합하여 bestHint를 찾고 등록해둡니다. 그리고 이제 실제 자원을 할당하는데, 이때도 hintProvider에 등록된 cpuManager, memoryManager, deviceManager를 통해 자원을 할당합니다.
func (s *containerScope) Admit(pod *v1.Pod) lifecycle.PodAdmitResult {
    for _, container := range append(pod.Spec.InitContainers, pod.Spec.Containers...) {
        bestHint, admit := s.calculateAffinity(pod, &container)
        klog.InfoS("Best TopologyHint", "bestHint", bestHint, "pod", klog.KObj(pod), "containerName", container.Name)

        if !admit {
            metrics.TopologyManagerAdmissionErrorsTotal.Inc()
            return admission.GetPodAdmitResult(&TopologyAffinityError{})
        }
        klog.InfoS("Topology Affinity", "bestHint", bestHint, "pod", klog.KObj(pod), "containerName", container.Name)
        s.setTopologyHints(string(pod.UID), container.Name, bestHint)

        err := s.allocateAlignedResources(pod, &container)
        if err != nil {
            metrics.TopologyManagerAdmissionErrorsTotal.Inc()
            return admission.GetPodAdmitResult(err)
        }
    }
    return admission.GetPodAdmitResult(nil)
}
func (s *scope) allocateAlignedResources(pod *v1.Pod, container *v1.Container) error {
    for _, provider := range s.hintProviders {
        err := provider.Allocate(pod, container)
        if err != nil {
            return err
        }
    }
    return nil
}
func (m *manager) Allocate(p *v1.Pod, c *v1.Container) error {
    // The pod is during the admission phase. We need to save the pod to avoid it
    // being cleaned before the admission ended
    m.setPodPendingAdmission(p)

    // Garbage collect any stranded resources before allocating CPUs.
    m.removeStaleState()

    m.Lock()
    defer m.Unlock()

    // Call down into the policy to assign this container CPUs if required.
    err := m.policy.Allocate(m.state, p, c)
    if err != nil {
        klog.ErrorS(err, "Allocate error")
        return err
    }

    return nil
}
// Allocate is called to pre-allocate memory resources during Pod admission.
func (m *manager) Allocate(pod *v1.Pod, container *v1.Container) error {
    // The pod is during the admission phase. We need to save the pod to avoid it
    // being cleaned before the admission ended
    m.setPodPendingAdmission(pod)

    // Garbage collect any stranded resources before allocation
    m.removeStaleState()

    m.Lock()
    defer m.Unlock()

    // Call down into the policy to assign this container memory if required.
    if err := m.policy.Allocate(m.state, pod, container); err != nil {
        klog.ErrorS(err, "Allocate error")
        return err
    }
    return nil
}
그럼 실제 각 cpuManager, memoryManager의 policy에서는 어떻게 m.policy.Allocate가 구현되어 있는 지 확인해보겠습니다.
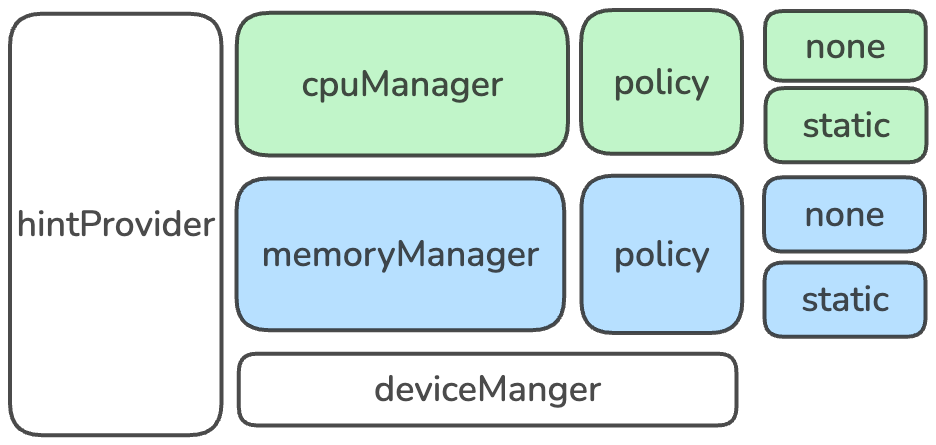
- cpuManager, memoryManager 모두
none policy와static policy를 갖습니다.
기본값은 none policy로 해당 정책일 때 Allocate는 어떤 자원 예약도 없이 끝납니다.
func (p *nonePolicy) Allocate(s state.State, pod *v1.Pod, container *v1.Container) error {
    return nil
}
func (p *none) Allocate(s state.State, pod *v1.Pod, container *v1.Container) error {
    return nil
}
static policy일 때는 아래와 같이 배타적 자원 할당이 발생합니다.
func (p *staticPolicy) Allocate(s state.State, pod *v1.Pod, container *v1.Container) (rerr error) {
    numCPUs := p.guaranteedCPUs(pod, container)
    if numCPUs == 0 {
        // container belongs in the shared pool (nothing to do; use default cpuset)
        return nil
    }

    ...
    }
    if cpuset, ok := s.GetCPUSet(string(pod.UID), container.Name); ok {
        p.updateCPUsToReuse(pod, container, cpuset)
        klog.InfoS("Static policy: container already present in state, skipping", "pod", klog.KObj(pod), "containerName", container.Name)
        return nil
    }

    // Call Topology Manager to get the aligned socket affinity across all hint providers.
    hint := p.affinity.GetAffinity(string(pod.UID), container.Name)
    klog.InfoS("Topology Affinity", "pod", klog.KObj(pod), "containerName", container.Name, "affinity", hint)

    // Allocate CPUs according to the NUMA affinity contained in the hint.
    cpuset, err := p.allocateCPUs(s, numCPUs, hint.NUMANodeAffinity, p.cpusToReuse[string(pod.UID)])
    if err != nil {
        klog.ErrorS(err, "Unable to allocate CPUs", "pod", klog.KObj(pod), "containerName", container.Name, "numCPUs", numCPUs)
        return err
    }
    s.SetCPUSet(string(pod.UID), container.Name, cpuset)
    p.updateCPUsToReuse(pod, container, cpuset)

    return nil
}
func (p *staticPolicy) Allocate(s state.State, pod *v1.Pod, container *v1.Container) (rerr error) {
    // allocate the memory only for guaranteed pods
    if v1qos.GetPodQOS(pod) != v1.PodQOSGuaranteed {
        return nil
    }

    podUID := string(pod.UID)
    klog.InfoS("Allocate", "pod", klog.KObj(pod), "containerName", container.Name)
    // container belongs in an exclusively allocated pool
    metrics.MemoryManagerPinningRequestTotal.Inc()
    defer func() {
        if rerr != nil {
            metrics.MemoryManagerPinningErrorsTotal.Inc()
        }
    }()
    if blocks := s.GetMemoryBlocks(podUID, container.Name); blocks != nil {
        p.updatePodReusableMemory(pod, container, blocks)

        klog.InfoS("Container already present in state, skipping", "pod", klog.KObj(pod), "containerName", container.Name)
        return nil
    }

    // Call Topology Manager to get the aligned affinity across all hint providers.
    hint := p.affinity.GetAffinity(podUID, container.Name)
    klog.InfoS("Got topology affinity", "pod", klog.KObj(pod), "podUID", pod.UID, "containerName", container.Name, "hint", hint)

    requestedResources, err := getRequestedResources(pod, container)
    if err != nil {
        return err
    }

    machineState := s.GetMachineState()
    bestHint := &hint
    // topology manager returned the hint with NUMA affinity nil
    // we should use the default NUMA affinity calculated the same way as for the topology manager
    if hint.NUMANodeAffinity == nil {
        defaultHint, err := p.getDefaultHint(machineState, pod, requestedResources)
        if err != nil {
            return err
        }

        if !defaultHint.Preferred && bestHint.Preferred {
            return fmt.Errorf("[memorymanager] failed to find the default preferred hint")
        }
        bestHint = defaultHint
    }

    // topology manager returns the hint that does not satisfy completely the container request
    // we should extend this hint to the one who will satisfy the request and include the current hint
    if !isAffinitySatisfyRequest(machineState, bestHint.NUMANodeAffinity, requestedResources) {
        extendedHint, err := p.extendTopologyManagerHint(machineState, pod, requestedResources, bestHint.NUMANodeAffinity)
        if err != nil {
            return err
        }

        if !extendedHint.Preferred && bestHint.Preferred {
            return fmt.Errorf("[memorymanager] failed to find the extended preferred hint")
        }
        bestHint = extendedHint
    }

    var containerBlocks []state.Block
    maskBits := bestHint.NUMANodeAffinity.GetBits()
    for resourceName, requestedSize := range requestedResources {
        // update memory blocks
        containerBlocks = append(containerBlocks, state.Block{
            NUMAAffinity: maskBits,
            Size:         requestedSize,
            Type:         resourceName,
        })

        podReusableMemory := p.getPodReusableMemory(pod, bestHint.NUMANodeAffinity, resourceName)
        if podReusableMemory >= requestedSize {
            requestedSize = 0
        } else {
            requestedSize -= podReusableMemory
        }

        // Update nodes memory state
        p.updateMachineState(machineState, maskBits, resourceName, requestedSize)
    }

    p.updatePodReusableMemory(pod, container, containerBlocks)

    s.SetMachineState(machineState)
    s.SetMemoryBlocks(podUID, container.Name, containerBlocks)

    // update init containers memory blocks to reflect the fact that we re-used init containers memory
    // it is possible that the size of the init container memory block will have 0 value, when all memory
    // allocated for it was re-used
    // we only do this so that the sum(memory_for_all_containers) == total amount of allocated memory to the pod, even
    // though the final state here doesn't accurately reflect what was (in reality) allocated to each container
    // TODO: we should refactor our state structs to reflect the amount of the re-used memory
    p.updateInitContainersMemoryBlocks(s, pod, container, containerBlocks)

    return nil
}
kubelet 커스텀
지금까지 topologyManager를 통해 각 hintProvider가 정책에 맞게 어떻게 자원을 할당하는 지 알아봤습니다.
이제 우리의 kubelet 커스텀 목표에 맞게 다시 생각해보면 cpuManager, memoryManager의 static policy를 잘 분석해서 변형하면 우리가 원하는 커스텀 목표를 달성할 수 있을 것 같습니다.
일단 기본적으로 topologyManager의 정책은 none입니다.
정렬을 고려하지 않죠 나머지 선택지는 best-effort, restricted, single-numa-node인데, 현재 우리의 목표에는 best-effort 정책이 가장 잘 맞을 것 같습니다.
restricted의 경우 topology 정렬이 안되면 Pod 할당을 거부하고, single-numa-node의 경우 cpuManager, memoryManager의 정책이 static이어야 하기 때문이죠
그래서 우리는 best-effort로 일단 정렬할 수 있으면 최대한 정렬하여 할당하고, 만약 불가능하면 불가능한대로 Pod를 할당하도록 하겠습니다. (발표 내용에도 실제 적용 후 Hint를 안주기도 하고 정렬이 풀리기도 했다는 내용을 봐서 우리는 강력한 제한을 하지 않았다는 것을 유추할 수 있습니다)
topologyManager의 정책은 best-effort로 가면서, cpuManager, memoryManager의 정책은 어떻게 해야할까요?
여기서 부터 실제 커스텀이 필요할 것 같습니다. 기존에 있는 none, static 정책으론 우리의 목표를 달성할 수 없기 때문입니다.
그래서 한번 numa-shared라는 새로운 정책을 만들어보겠습니다. 작성하기 전에 어떤 식으로 정책을 작성해야 하는 지 참고하기 위해 staticPolicy를 분석해보겠습니다.
staticPolicy (CPU manager)
CPU manager의 staticPolicy의 핵심 개념은 아래 코드의 주석을 통해 이해할 수 있습니다.
// staticPolicy is a CPU manager policy that does not change CPU
// assignments for exclusively pinned guaranteed containers after the main
// container process starts.
//
// This policy allocates CPUs exclusively for a container if all the following
// conditions are met:
//
// - The pod QoS class is Guaranteed.
// - The CPU request is a positive integer.
//
// The static policy maintains the following sets of logical CPUs:
//
//   - SHARED: Burstable, BestEffort, and non-integral Guaranteed containers
//     run here. Initially this contains all CPU IDs on the system. As
//     exclusive allocations are created and destroyed, this CPU set shrinks
//     and grows, accordingly. This is stored in the state as the default
//     CPU set.
//
//   - RESERVED: A subset of the shared pool which is not exclusively
//     allocatable. The membership of this pool is static for the lifetime of
//     the Kubelet. The size of the reserved pool is
//     ceil(systemreserved.cpu + kubereserved.cpu).
//     Reserved CPUs are taken topologically starting with lowest-indexed
//     physical core, as reported by cAdvisor.
//
//   - ASSIGNABLE: Equal to SHARED - RESERVED. Exclusive CPUs are allocated
//     from this pool.
//
//   - EXCLUSIVE ALLOCATIONS: CPU sets assigned exclusively to one container.
//     These are stored as explicit assignments in the state.
//
// When an exclusive allocation is made, the static policy also updates the
// default cpuset in the state abstraction. The CPU manager's periodic
// reconcile loop takes care of rewriting the cpuset in cgroupfs for any
// containers that may be running in the shared pool. For this reason,
// applications running within exclusively-allocated containers must tolerate
// potentially sharing their allocated CPUs for up to the CPU manager
// reconcile period.
type staticPolicy struct {
    // cpu socket topology
    topology *topology.CPUTopology
    // set of CPUs that is not available for exclusive assignment
    reservedCPUs cpuset.CPUSet
    // Superset of reservedCPUs. It includes not just the reservedCPUs themselves,
    // but also any siblings of those reservedCPUs on the same physical die.
    // NOTE: If the reserved set includes full physical CPUs from the beginning
    // (e.g. only reserved pairs of core siblings) this set is expected to be
    // identical to the reserved set.
    reservedPhysicalCPUs cpuset.CPUSet
    // topology manager reference to get container Topology affinity
    affinity topologymanager.Store
    // set of CPUs to reuse across allocations in a pod
    cpusToReuse map[string]cpuset.CPUSet
    // options allow to fine-tune the behaviour of the policy
    options StaticPolicyOptions
}
주석의 내용을 정리하면 아래와 같습니다.
staticPolicy는 메인 컨테이너 프로세스가 시작된 이후, 배타적으로 고정(pinned)된 Guaranteed 컨테이너의 CPU 할당을 변경하지 않는 CPU manager 정책입니다.
이 정책은 아래 조건을 만족하는 컨테이너에 대해 CPU를 배타적으로 할당합니다.
- Pod의 QoS가 Guaranteed인 경우
- CPU request가 양의 정수인 경우
static policy는 아래 논리적 CPU들의 집합을 관리합니다.
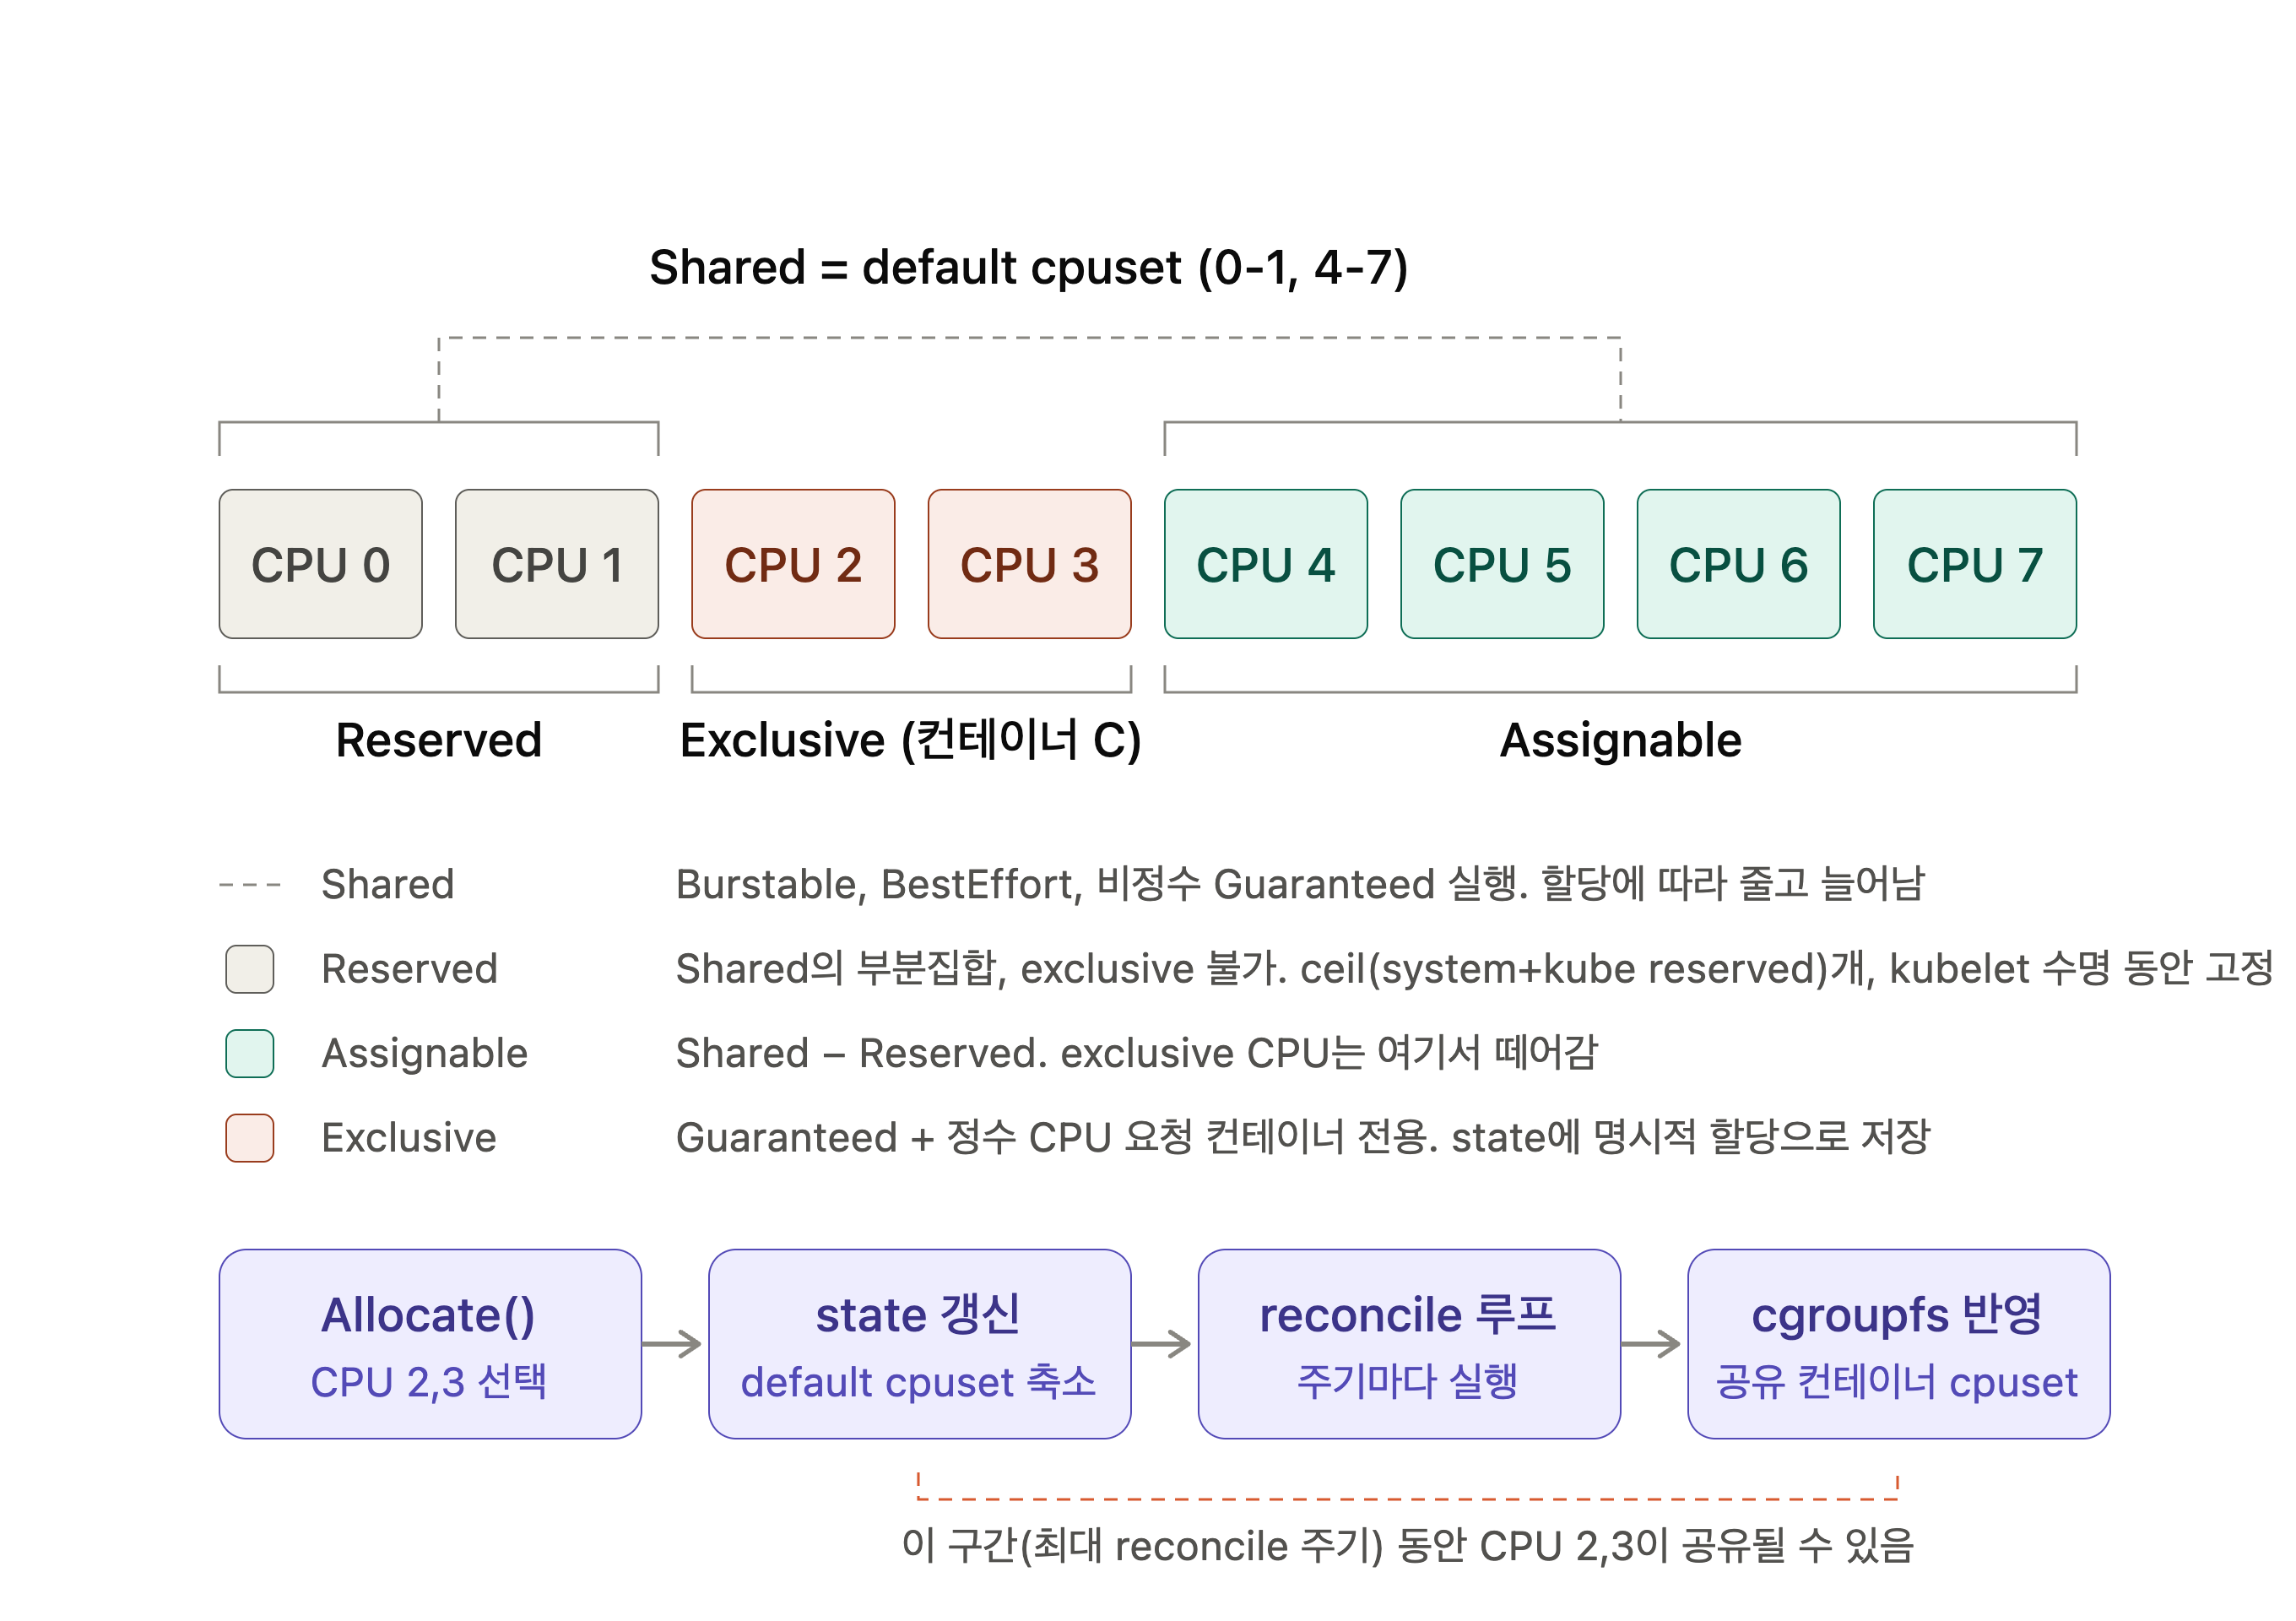
-
SHARED: Burstable, BestEffort, 그리고 non-integral Guaranteed containers들은 여기서 동작합니다. 처음에 이 영역에는 시스템의 모든 CPU ID가 포함됩니다. 배타적 할당이 생성 및 삭제되면서 이 CPU 집합은 감소 및 증가합니다. 이 영역은 state에 default CPU set으로 저장됩니다. -
RESERVED: shared pool의 부분 집합으로서 배타적으로 할당되지 않는 영역입니다. 이 영역의 구성원은 kubelet 수명주기 동안 정적으로 유지됩니다. reserved pool의 크기는 systemreserved.cpu + kubereserved.cpu의 반올림 값입니다. reserved CPU는 cAdvisor가 확인한 가장 낮은 인덱스의 물리 코어부터 토폴로지 순서대로 선택됩니다. -
ASSIGNABLE: SHARED 영역에서 RESERVED 영역을 뺀 영역입니다. 배타적 CPU 할당을 위해 이 pool에서 가져옵니다 -
EXCLUSIVE ALLOCATIONS: 한 컨테이너에 독점적으로 할당된 CPU set입니다. 이 할당들은 state에 명시적인 값으로 저장됩니다.
배타적(exclusive) 할당이 이루어지면, static 정책은 state 추상화 계층의 기본(default) cpuset도 함께 갱신합니다. 공유 풀에서 실행 중일 수 있는 컨테이너들의 cgroupfs cpuset을 다시 쓰는 작업은 CPU 매니저의 주기적인 reconcile 루프가 담당합니다. 이 때문에 배타적으로 할당받은 컨테이너 안에서 실행되는 애플리케이션은, 최대 CPU 매니저 reconcile 주기 동안 할당받은 CPU를 다른 컨테이너와 공유하게 될 수 있음을 감수해야 합니다.
이제 코드의 자세한 부분들을 하나 씩 확인해보겠습니다.
먼저 인터페이스 구현 검증 부입니다. 아래 부분을 통해 staticPolicy가 Policy 인터페이스를 구현하고 있는 지 검증할 수 있습니다.
구현해야 하는 Policy 인터페이스는 총 7개의 메서드를 갖고 아래와 같습니다.
type Policy interface {
    Name() string
    Start(s state.State) error
    // Allocate call is idempotent
    Allocate(s state.State, pod *v1.Pod, container *v1.Container) error
    // RemoveContainer call is idempotent
    RemoveContainer(s state.State, podUID string, containerName string) error
    // GetTopologyHints implements the topologymanager.HintProvider Interface
    // and is consulted to achieve NUMA aware resource alignment among this
    // and other resource controllers.
    GetTopologyHints(s state.State, pod *v1.Pod, container *v1.Container) map[string][]topologymanager.TopologyHint
    // GetPodTopologyHints implements the topologymanager.HintProvider Interface
    // and is consulted to achieve NUMA aware resource alignment per Pod
    // among this and other resource controllers.
    GetPodTopologyHints(s state.State, pod *v1.Pod) map[string][]topologymanager.TopologyHint
    // GetAllocatableCPUs returns the total set of CPUs available for allocation.
    GetAllocatableCPUs(m state.State) cpuset.CPUSet
}
하나씩 어떻게 구현했는 지 확인해보겠습니다.
-
Name()정책 이름을 반환합니다
-
Start(s state.State) errorkubelet 시작 후 이전 상태를 이어받아 정합성을 확인합니다
-
Allocate(s state.State, pod *v1.Pod, container *v1.Container) error이 함수는 state에 자원을 할당 기록하는 역할을 수행합니다
numCPUs := p.guaranteedCPUs(pod, container) if numCPUs == 0 { // container belongs in the shared pool (nothing to do; use default cpuset) return nil } klog.InfoS("Static policy: Allocate", "pod", klog.KObj(pod), "containerName", container.Name) // container belongs in an exclusively allocated pool metrics.CPUManagerPinningRequestsTotal.Inc() defer func() { if rerr != nil { metrics.CPUManagerPinningErrorsTotal.Inc() } }()- p.guaranteedCPUs(pod, container)를 통해 조건이 었던 (QoS, 양의 정수)를 확인합니다 -> 아닐 경우 0으로 반환됩니다.
- 0이면 공유 풀에서 돌 컨테이너라는 뜻이라 아무것도 기록하지 않습니다. state에 기록이 없으면 GetCPUSetOrDefault가 default cpuset을 돌려주니, "기록 안 함 = 공유 풀 사용"이 됩니다.
if cpuset, ok := s.GetCPUSet(string(pod.UID), container.Name); ok { p.updateCPUsToReuse(pod, container, cpuset) klog.InfoS("Static policy: container already present in state, skipping", "pod", klog.KObj(pod), "containerName", container.Name) return nil }- s.GetCPUSet(string(pod.UID), container.Name)을 통해 이미 할당된 컨테이너인 지 확인합니다(멱등성).
- p.updateCPUsToReuse(pod, container, cpuset)를 통해 state(디스크에 영속, 컨테이너별 결과)와 cpusToReuse(메모리, pod 단위 진행 중 계산)는 따로 관리되고, 재시작 후에는 후자가 사라지기 때문에 이미 할당된 컨테이너를 만났을 때도 그 결과를 장부에 다시 반영해서 복원합니다
- 참고로 cpusToReuse란 init 컨테이너에 할당된 자원 재활용을 위해 런타임 시 메모리에서 관리 값입니다
// Call Topology Manager to get the aligned socket affinity across all hint providers. hint := p.affinity.GetAffinity(string(pod.UID), container.Name) klog.InfoS("Topology Affinity", "pod", klog.KObj(pod), "containerName", container.Name, "affinity", hint)- admission 단계에서 Topology Manager는 모든 hint provider의 GetTopologyHints 결과를 합쳐서 "이 컨테이너는 어느 NUMA 노드에 두는 게 좋다"는 최종 결론을 내리고 저장해둡니다.
- 여기서는 그 결과를 꺼내옵니다. CPU와 GPU/NIC, 메모리를 같은 NUMA 노드에 맞추는 게 목적입니다.
// Allocate CPUs according to the NUMA affinity contained in the hint. cpuset, err := p.allocateCPUs(s, numCPUs, hint.NUMANodeAffinity, p.cpusToReuse[string(pod.UID)]) if err != nil { klog.ErrorS(err, "Unable to allocate CPUs", "pod", klog.KObj(pod), "containerName", container.Name, "numCPUs", numCPUs) return err }- allocateCPUs 내부에서는 먼저 후보를 정합니다. 후보는 "assignable(default cpuset − reserved)"과 "재사용 가능한 init 컨테이너 CPU"의 합집합이에요.
- 그다음 hint의 NUMA 노드에 속한 CPU부터 takeByTopology로 고르고, 모자라면 나머지 후보에서 채웁니다.
- takeByTopology는 소켓 → NUMA → 물리 코어 → 스레드 순으로 가능한 한 큰 덩어리 단위로 떼어가서 캐시와 코어 공유를 최소화해요.
- 마지막으로 고른 CPU를 default cpuset에서 빼서 SetDefaultCPUSet으로 저장합니다. 그림에서 SHARED에 구멍이 생기는 게 바로 이 순간이에요. 후보가 모자라면 에러를 반환하고 admission이 실패합니다.
- "이 pod의 이 컨테이너는 이 cpuset"을 state에 명시적으로 기록합니다. 이후 컨테이너 생성 시 PreCreateContainer가 이 값을 읽어서 컨테이너의 cpuset으로 넣고, reconcile 루프도 이 값을 기준으로 삼아요.
- 체크포인트 파일에도 저장되니 kubelet이 재시작돼도 유지되고, 재시작 후에는 4번의 멱등성 분기를 타게 됩니다. 이어서 재사용 장부를 갱신하는데, init 컨테이너였다면 방금 받은 CPU를 재사용 풀에 넣습니다.
-
RemoveContainer(s state.State, podUID string, containerName string) error- 이 함수는 state에서 제거할 container의 할당을 제거한 뒤, default cpu set (즉 Shared Pool)으로 추가하는 작업을 수행합니다.
- CPU 재사용 때문에 같은 pod 안에서 두 컨테이너의 state 기록이 같은 CPU를 가리킬 수 있기 때문에 toRelease = toRelease.Difference(cpusInUse) 과정을 수행합니다.
func (p *staticPolicy) RemoveContainer(s state.State, podUID string, containerName string) error { klog.InfoS("Static policy: RemoveContainer", "podUID", podUID, "containerName", containerName) cpusInUse := getAssignedCPUsOfSiblings(s, podUID, containerName) if toRelease, ok := s.GetCPUSet(podUID, containerName); ok { s.Delete(podUID, containerName) // Mutate the shared pool, adding released cpus. toRelease = toRelease.Difference(cpusInUse) s.SetDefaultCPUSet(s.GetDefaultCPUSet().Union(toRelease)) } return nil } -
GetTopologyHints(s state.State, pod *v1.Pod, container *v1.Container) map[string][]topologymanager.TopologyHint- generateCPUTopologyHints 함수를 호출해서 TopologyHints를 가져오는 함수입니다.
- 사실상 중요한 로직은 generateCPUTopologyHints에서 구현됩니다.
- 이 함수의 역할은 CPU Request 검증, 이미 할당되어 있는 지 확인 (제대로 할당 되었는지도 확인)
func (p *staticPolicy) GetTopologyHints(s state.State, pod *v1.Pod, container *v1.Container) map[string][]topologymanager.TopologyHint { // Get a count of how many guaranteed CPUs have been requested. requested := p.guaranteedCPUs(pod, container) // Number of required CPUs is not an integer or a container is not part of the Guaranteed QoS class. // It will be treated by the TopologyManager as having no preference and cause it to ignore this // resource when considering pod alignment. // In terms of hints, this is equal to: TopologyHints[NUMANodeAffinity: nil, Preferred: true]. if requested == 0 { return nil } // Short circuit to regenerate the same hints if there are already // guaranteed CPUs allocated to the Container. This might happen after a // kubelet restart, for example. if allocated, exists := s.GetCPUSet(string(pod.UID), container.Name); exists { if allocated.Size() != requested { klog.ErrorS(nil, "CPUs already allocated to container with different number than request", "pod", klog.KObj(pod), "containerName", container.Name, "requestedSize", requested, "allocatedSize", allocated.Size()) // An empty list of hints will be treated as a preference that cannot be satisfied. // In definition of hints this is equal to: TopologyHint[NUMANodeAffinity: nil, Preferred: false]. // For all but the best-effort policy, the Topology Manager will throw a pod-admission error. return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): {}, } } klog.InfoS("Regenerating TopologyHints for CPUs already allocated", "pod", klog.KObj(pod), "containerName", container.Name) return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): p.generateCPUTopologyHints(allocated, cpuset.CPUSet{}, requested), } } // Get a list of available CPUs. available := p.GetAvailableCPUs(s) // Get a list of reusable CPUs (e.g. CPUs reused from initContainers). // It should be an empty CPUSet for a newly created pod. reusable := p.cpusToReuse[string(pod.UID)] // Generate hints. cpuHints := p.generateCPUTopologyHints(available, reusable, requested) klog.InfoS("TopologyHints generated", "pod", klog.KObj(pod), "containerName", container.Name, "cpuHints", cpuHints) return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): cpuHints, } } -
GetPodTopologyHints(s state.State, pod *v1.Pod) map[string][]topologymanager.TopologyHint- 이 함수는 GetTopologyHints 함수와 거의 유사하지만, Container 단위가 아닌 Pod 전체 단위로 할당을 고려할 때 TopologyHints를 계산합니다.
func (p *staticPolicy) GetPodTopologyHints(s state.State, pod *v1.Pod) map[string][]topologymanager.TopologyHint { // Get a count of how many guaranteed CPUs have been requested by Pod. requested := p.podGuaranteedCPUs(pod) // Number of required CPUs is not an integer or a pod is not part of the Guaranteed QoS class. // It will be treated by the TopologyManager as having no preference and cause it to ignore this // resource when considering pod alignment. // In terms of hints, this is equal to: TopologyHints[NUMANodeAffinity: nil, Preferred: true]. if requested == 0 { return nil } assignedCPUs := cpuset.New() for _, container := range append(pod.Spec.InitContainers, pod.Spec.Containers...) { requestedByContainer := p.guaranteedCPUs(pod, &container) // Short circuit to regenerate the same hints if there are already // guaranteed CPUs allocated to the Container. This might happen after a // kubelet restart, for example. if allocated, exists := s.GetCPUSet(string(pod.UID), container.Name); exists { if allocated.Size() != requestedByContainer { klog.ErrorS(nil, "CPUs already allocated to container with different number than request", "pod", klog.KObj(pod), "containerName", container.Name, "allocatedSize", requested, "requestedByContainer", requestedByContainer, "allocatedSize", allocated.Size()) // An empty list of hints will be treated as a preference that cannot be satisfied. // In definition of hints this is equal to: TopologyHint[NUMANodeAffinity: nil, Preferred: false]. // For all but the best-effort policy, the Topology Manager will throw a pod-admission error. return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): {}, } } // A set of CPUs already assigned to containers in this pod assignedCPUs = assignedCPUs.Union(allocated) } } if assignedCPUs.Size() == requested { klog.InfoS("Regenerating TopologyHints for CPUs already allocated", "pod", klog.KObj(pod)) return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): p.generateCPUTopologyHints(assignedCPUs, cpuset.CPUSet{}, requested), } } // Get a list of available CPUs. available := p.GetAvailableCPUs(s) // Get a list of reusable CPUs (e.g. CPUs reused from initContainers). // It should be an empty CPUSet for a newly created pod. reusable := p.cpusToReuse[string(pod.UID)] // Ensure any CPUs already assigned to containers in this pod are included as part of the hint generation. reusable = reusable.Union(assignedCPUs) // Generate hints. cpuHints := p.generateCPUTopologyHints(available, reusable, requested) klog.InfoS("TopologyHints generated", "pod", klog.KObj(pod), "cpuHints", cpuHints) return map[string][]topologymanager.TopologyHint{ string(v1.ResourceCPU): cpuHints, } } -
GetAllocatableCPUs(m state.State) cpuset.CPUSet- 이 함수는 배타적으로 할당 가능한 CPU를 계산해 반환하는 함수입니다.
- p.topology.CPUDetails.CPUs()의 반환 값은 노드의 모든 논리 CPU(하드웨어 스레드) ID 집합이에요. 지금 누가 쓰고 있는지와는 상관없는 "이 노드에 CPU가 몇 번부터 몇 번까지 있나"입니다.
- p.topology는 *topology.CPUTopology예요. kubelet이 뜰 때 cAdvisor가 수집한 머신 정보(MachineInfo)로부터 topology.Discover()가 만들고, NewManager → NewStaticPolicy로 넘겨줍니다. 그 안의 CPUDetails는 논리 CPU ID를 키로 하는 맵입니다
- 정리하면 배타적으로 할당 가능한 CPU를 state에 의존하지 않고 실제 cAdvisor를 통해 전달 받은 topology를 바탕으로 논리 CPU ID 집합을 가져온 뒤 reservedCPUs 영역을 제외한 값만 반환합니다
policy 인터페이스에서 구현해야하는 7가지 메서드를 살펴봤고, 그 중 TopologyHint를 가져오는 메서드에서 쓰이는 함수(generateCPUTopologyHints)를 한번 자세히 알아보겠습니다.
func (p *staticPolicy) generateCPUTopologyHints(availableCPUs cpuset.CPUSet, reusableCPUs cpuset.CPUSet, request int) []topologymanager.TopologyHint {
    // Initialize minAffinitySize to include all NUMA Nodes.
    minAffinitySize := p.topology.CPUDetails.NUMANodes().Size()

    // Iterate through all combinations of numa nodes bitmask and build hints from them.
    hints := []topologymanager.TopologyHint{}
    bitmask.IterateBitMasks(p.topology.CPUDetails.NUMANodes().List(), func(mask bitmask.BitMask) {
        // First, update minAffinitySize for the current request size.
        cpusInMask := p.topology.CPUDetails.CPUsInNUMANodes(mask.GetBits()...).Size()
        if cpusInMask >= request && mask.Count() < minAffinitySize {
            minAffinitySize = mask.Count()
        }

        // Then check to see if we have enough CPUs available on the current
        // numa node bitmask to satisfy the CPU request.
        numMatching := 0
        for _, c := range reusableCPUs.List() {
            // Disregard this mask if its NUMANode isn't part of it.
            if !mask.IsSet(p.topology.CPUDetails[c].NUMANodeID) {
                return
            }
            numMatching++
        }

        // Finally, check to see if enough available CPUs remain on the current
        // NUMA node combination to satisfy the CPU request.
        for _, c := range availableCPUs.List() {
            if mask.IsSet(p.topology.CPUDetails[c].NUMANodeID) {
                numMatching++
            }
        }

        // If they don't, then move onto the next combination.
        if numMatching < request {
            return
        }

        // Otherwise, create a new hint from the numa node bitmask and add it to the
        // list of hints.  We set all hint preferences to 'false' on the first
        // pass through.
        hints = append(hints, topologymanager.TopologyHint{
            NUMANodeAffinity: mask,
            Preferred:        false,
        })
    })

    // Loop back through all hints and update the 'Preferred' field based on
    // counting the number of bits sets in the affinity mask and comparing it
    // to the minAffinitySize. Only those with an equal number of bits set (and
    // with a minimal set of numa nodes) will be considered preferred.
    for i := range hints {
        if p.options.AlignBySocket && p.isHintSocketAligned(hints[i], minAffinitySize) {
            hints[i].Preferred = true
            continue
        }
        if hints[i].NUMANodeAffinity.Count() == minAffinitySize {
            hints[i].Preferred = true
        }
    }

    return hints
}
다음은 staticPolicy를 생성하는 NewStaticPolicy 함수입니다. 크게 4가지 기능을 수행합니다.
- 정책 옵션 검증
- staticPolicy 객체 생성
- reservedCPUs (cpuset.CPUSet) 확인
- reservedPhysicalCPUs (cpuset.CPUSet) 확인
// NewStaticPolicy returns a CPU manager policy that does not change CPU
// assignments for exclusively pinned guaranteed containers after the main
// container process starts.
func NewStaticPolicy(topology *topology.CPUTopology, numReservedCPUs int, reservedCPUs cpuset.CPUSet, affinity topologymanager.Store, cpuPolicyOptions map[string]string) (Policy, error) {
    opts, err := NewStaticPolicyOptions(cpuPolicyOptions)
    if err != nil {
        return nil, err
    }
    err = ValidateStaticPolicyOptions(opts, topology, affinity)
    if err != nil {
        return nil, err
    }

    klog.InfoS("Static policy created with configuration", "options", opts)

    policy := &staticPolicy{
        topology:    topology,
        affinity:    affinity,
        cpusToReuse: make(map[string]cpuset.CPUSet),
        options:     opts,
    }

    allCPUs := topology.CPUDetails.CPUs()
    var reserved cpuset.CPUSet
    if reservedCPUs.Size() > 0 {
        reserved = reservedCPUs
    } else {
        // takeByTopology allocates CPUs associated with low-numbered cores from
        // allCPUs.
        //
        // For example: Given a system with 8 CPUs available and HT enabled,
        // if numReservedCPUs=2, then reserved={0,4}
        reserved, _ = policy.takeByTopology(allCPUs, numReservedCPUs)
    }

    if reserved.Size() != numReservedCPUs {
        err := fmt.Errorf("[cpumanager] unable to reserve the required amount of CPUs (size of %s did not equal %d)", reserved, numReservedCPUs)
        return nil, err
    }

    var reservedPhysicalCPUs cpuset.CPUSet
    for _, cpu := range reserved.UnsortedList() {
        core, err := topology.CPUCoreID(cpu)
        if err != nil {
            return nil, fmt.Errorf("[cpumanager] unable to build the reserved physical CPUs from the reserved set: %w", err)
        }
        reservedPhysicalCPUs = reservedPhysicalCPUs.Union(topology.CPUDetails.CPUsInCores(core))
    }

    klog.InfoS("Reserved CPUs not available for exclusive assignment", "reservedSize", reserved.Size(), "reserved", reserved, "reservedPhysicalCPUs", reservedPhysicalCPUs)
    policy.reservedCPUs = reserved
    policy.reservedPhysicalCPUs = reservedPhysicalCPUs

    return policy, nil
}
staticPolicy (Memory Manager)
이제 Memory Manager의 staticPolicy를 확인해보겠습니다.
const policyTypeStatic policyType = "Static"

type systemReservedMemory map[int]map[v1.ResourceName]uint64
type reusableMemory map[string]map[string]map[v1.ResourceName]uint64

// staticPolicy is implementation of the policy interface for the static policy
type staticPolicy struct {
    // machineInfo contains machine memory related information
    machineInfo *cadvisorapi.MachineInfo
    // reserved contains memory that reserved for kube
    systemReserved systemReservedMemory
    // topology manager reference to get container Topology affinity
    affinity topologymanager.Store
    // initContainersReusableMemory contains the memory allocated for init
    // containers that can be reused.
    // Note that the restartable init container memory is not included here,
    // because it is not reusable.
    initContainersReusableMemory reusableMemory
}
staticPolicy와 nonePolicy의 가장 큰 차이는 자원을 특정 NUMA Node에 고정 하냐 안하냐 입니다. 그래서 staticPolicy에서는 자원 할당 및 해제를 state에 기록하는 반면 nonePolicy에서는 어떠한 행위도 하지 않습니다. CPU Manager와 Memory Manager의 가장 큰 차이는 관리하는 대상입니다.
CPU의 경우 공유가능한 자원이기 때문에 nonePolicy에서는 QoS에 상관 없이 컨테이너의 request가 노드 총 코어수 만큼 할당될 수 있습니다. 그리고 그 할당된 자원 안에서 QoS에 따라 스케줄링이 됩니다. Guaranteed면 가장 나중에 자원을 뺏고, besteffort면 가장 먼저 자원을 뺏고 이런식으로요 그러다보면 컨테이너들은 클러스터에 속한 다른 여유있는 노드들을 찾아 이리 저리 돌아다닐 수 있습니다. 또한 같은 노드 안에서도 존재하는 여러 NUMA Node의 코어를 돌아다닐 수 있죠
하지만 staticPolicy에서는 container가 동작해야하는 CPU 코어가 고정됩니다. 정확히 말하면 어떤 노드 안에 어떤 NUMA Node 안에 어떤 CPU 코어에 돌건지 cpuset.cpu 값으로 고정됩니다. 그렇게 되면 아까 nonePolicy에서 말했던 것처럼 이리 저리 떠돌아다니는 Container가 이 배타적으로 할당된 CPU 코어를 못쓰게끔 알려줘야합니다.
그래서 위에서 알아본 것처럼 배타적 할당 풀, 공유 풀 이런식으로 풀을 관리해야 하는 것입니다. 이때 만약 배타적으로 1번 코어를 할당해야하는데, 1번 코어를 이미 할당 받은 다른 비 Guaranteed 파드가 있다면 어떻게 될까요?
---설명계속 작성
func (p *staticPolicy) allocateCPUs(s state.State, numCPUs int, numaAffinity bitmask.BitMask, reusableCPUs cpuset.CPUSet) (cpuset.CPUSet, error) {
    ...
    // Remove allocated CPUs from the shared CPUSet.
    s.SetDefaultCPUSet(s.GetDefaultCPUSet().Difference(result))
    ...
}
func (m *manager) Start(activePods ActivePodsFunc, sourcesReady config.SourcesReady, podStatusProvider status.PodStatusProvider, containerRuntime runtimeService, initialContainers containermap.ContainerMap) error {
    ...
    // Periodically call m.reconcileState() to continue to keep the CPU sets of
    // all pods in sync with and guaranteed CPUs handed out among them.
    go wait.Until(func() { m.reconcileState() }, m.reconcilePeriod, wait.NeverStop)
    ...
}
func (m *manager) reconcileState() (success []reconciledContainer, failure []reconciledContainer) {
    ...
    for _, pod := range m.activePods() {
        pstatus, ok := m.podStatusProvider.GetPodStatus(pod.UID)
        if !ok {
            klog.V(4).InfoS("ReconcileState: skipping pod; status not found", "pod", klog.KObj(pod))
            failure = append(failure, reconciledContainer{pod.Name, "", ""})
            continue
        }

        allContainers := pod.Spec.InitContainers
        allContainers = append(allContainers, pod.Spec.Containers...)
        for _, container := range allContainers {
            ...

            cset := m.state.GetCPUSetOrDefault(string(pod.UID), container.Name)
            if cset.IsEmpty() {
                // NOTE: This should not happen outside of tests.
                klog.V(4).InfoS("ReconcileState: skipping container; assigned cpuset is empty", "pod", klog.KObj(pod), "containerName", container.Name)
                failure = append(failure, reconciledContainer{pod.Name, container.Name, containerID})
                continue
            }

            lcset := m.lastUpdateState.GetCPUSetOrDefault(string(pod.UID), container.Name)
            if !cset.Equals(lcset) {
                klog.V(4).InfoS("ReconcileState: updating container", "pod", klog.KObj(pod), "containerName", container.Name, "containerID", containerID, "cpuSet", cset)
                err = m.updateContainerCPUSet(ctx, containerID, cset)
                if err != nil {
                    klog.ErrorS(err, "ReconcileState: failed to update container", "pod", klog.KObj(pod), "containerName", container.Name, "containerID", containerID, "cpuSet", cset)
                    failure = append(failure, reconciledContainer{pod.Name, container.Name, containerID})
                    continue
                }
                m.lastUpdateState.SetCPUSet(string(pod.UID), container.Name, cset)
            }
            success = append(success, reconciledContainer{pod.Name, container.Name, containerID})
        }
    }
    return success, failure
}
정리하면 CPU는 경합 자체를 막아야 하므로 나머지 컨테이너를 해당 코어에서 배제하는 반면, Memory는 NUMA 로컬 용량만 확보되면 공존이 허용되므로 나머지 컨테이너를 배제하지 않고 용량 회계로 관리합니다.
먼저 인터페이스 구현 검증 부입니다. 아래 부분을 통해 staticPolicy가 Policy 인터페이스를 구현하고 있는 지 검증할 수 있습니다.
마찬가지로 구현해야 하는 Policy 인터페이스는 총 7개의 메서드를 갖고 아래와 같습니다.
type Policy interface {
    Name() string
    Start(s state.State) error
    // Allocate call is idempotent
    Allocate(s state.State, pod *v1.Pod, container *v1.Container) error
    // RemoveContainer call is idempotent
    RemoveContainer(s state.State, podUID string, containerName string) error
    // GetTopologyHints implements the topologymanager.HintProvider Interface
    // and is consulted to achieve NUMA aware resource alignment among this
    // and other resource controllers.
    GetTopologyHints(s state.State, pod *v1.Pod, container *v1.Container) map[string][]topologymanager.TopologyHint
    // GetPodTopologyHints implements the topologymanager.HintProvider Interface
    // and is consulted to achieve NUMA aware resource alignment per Pod
    // among this and other resource controllers.
    GetPodTopologyHints(s state.State, pod *v1.Pod) map[string][]topologymanager.TopologyHint
    // GetAllocatableCPUs returns the total set of CPUs available for allocation.
    GetAllocatableCPUs(m state.State) cpuset.CPUSet
}
하나씩 어떻게 구현했는 지 확인해보겠습니다.
-
Name()정책 이름을 반환합니다
-
Start(s state.State) errorkubelet 시작 후 이전 상태를 이어받아 정합성을 확인합니다
-
Allocate(s state.State, pod *v1.Pod, container *v1.Container) error이 함수는 state에 자원을 할당 기록하는 역할을 수행합니다
    // allocate the memory only for guaranteed pods
    if v1qos.GetPodQOS(pod) != v1.PodQOSGuaranteed {
        return nil
    }

    podUID := string(pod.UID)
    klog.InfoS("Allocate", "pod", klog.KObj(pod), "containerName", container.Name)
    // container belongs in an exclusively allocated pool
    metrics.MemoryManagerPinningRequestTotal.Inc()
    defer func() {
        if rerr != nil {
            metrics.MemoryManagerPinningErrorsTotal.Inc()
        }
    }()
if v1qos.GetPodQOS(pod) != v1.PodQOSGuaranteed조건문을 통해 Pod의 QoS가 Guaranteed 인지 확인합니다 -> 아닐 경우 nil을 반환됩니다.
-
https://www.minzkn.com/linuxkernel/pages/numa.html#numa-fault ↩
-
https://kubernetes.io/docs/tasks/administer-cluster/cpu-management-policies/#static-policy-configuration ↩
-
https://kubernetes.io/docs/tasks/administer-cluster/memory-manager/#policy-static ↩
-
https://kubernetes.io/docs/tasks/administer-cluster/topology-manager/#policy-single-numa-node ↩